 ovobrowser
快速定位文章內容
2026 GitHub開源爬蟲項目推薦:10個值得收藏的工具,附ovo Browser自動化集成指南
從AI網頁採集、傳統爬蟲框架、瀏覽器自動化到Go併發抓取,盤點10個真實存在的GitHub開源項目,核對項目用途、科技棧與開源協定,並介紹ovo Browser官方GitHub倉庫和本地API如何與Playwright、Puppeteer等工具銜接,幫助開發者搭建更清晰、可維護的網頁數據工作流。
想搭建網頁資料獲取系統,不一定要從零寫爬蟲。 GitHub上已經有不少成熟的開源項目,覆蓋了傳統HTTP抓取、JavaScript頁面渲染、瀏覽器自動化、AI內容選取和併發任務調度等不同環節。
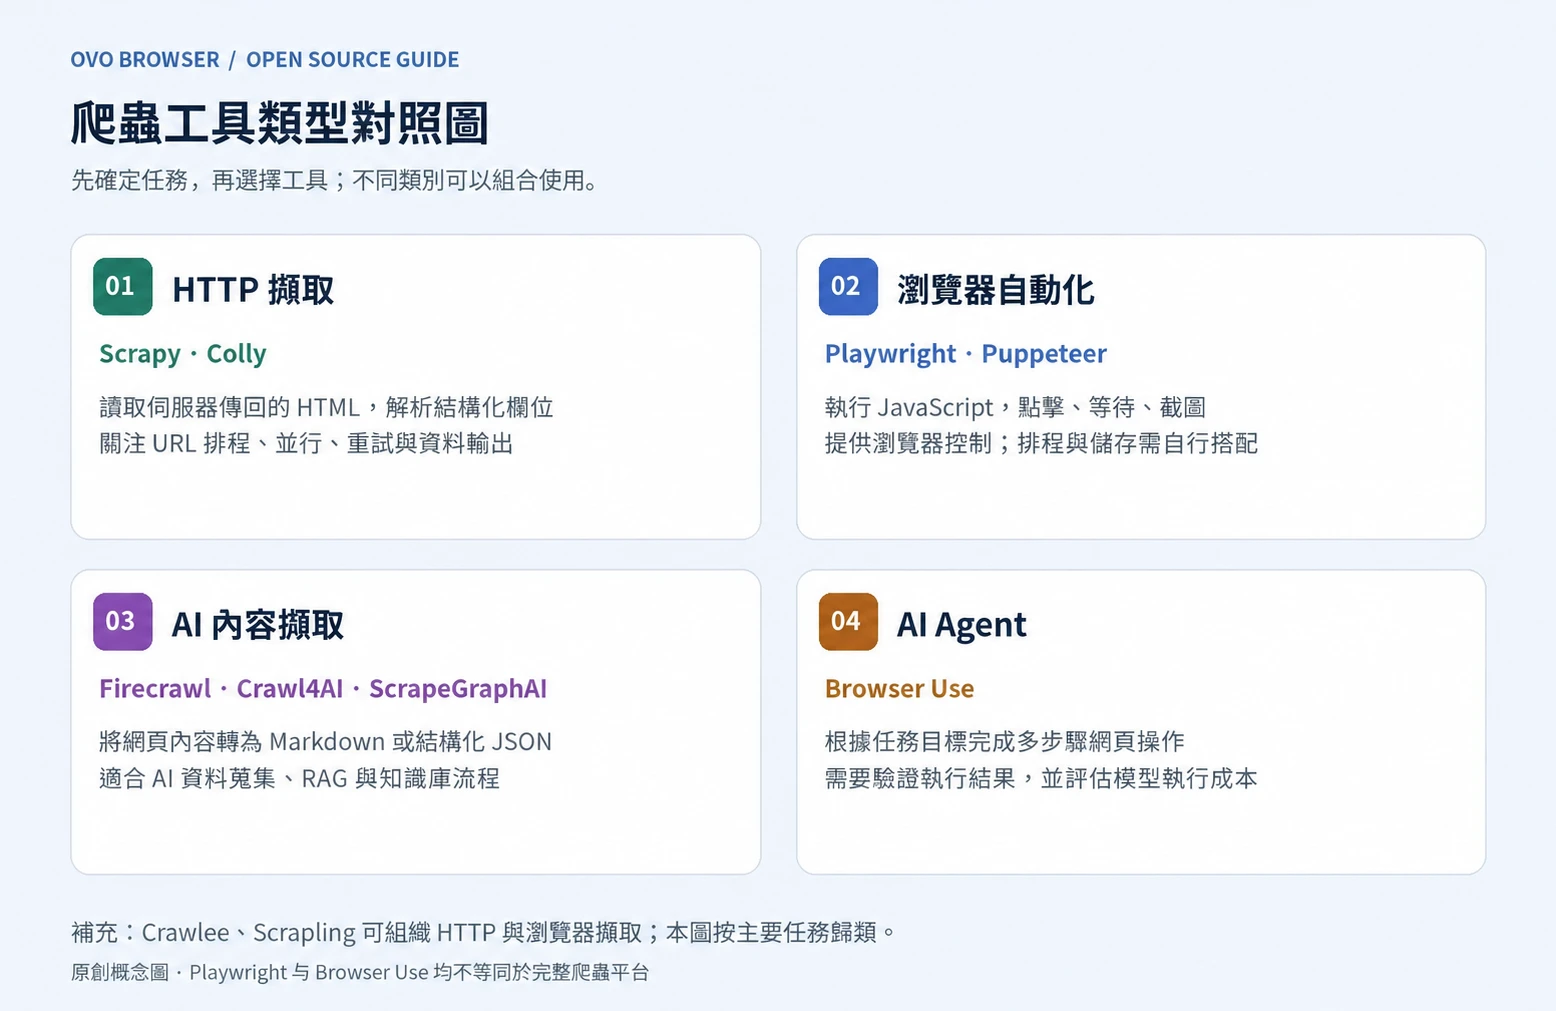
但“爬蟲項目”並不是一個單一類別:Scrapy、Colly更偏向採集框架; Playwright、Puppeteer負責瀏覽器控制; Browser Use面向AI Agent的多步驟網頁操作; Firecrawl、Crawl4AI和ScrapeGraphAI則更強調網頁內容結構化與AI工作流。 選型時先確認任務,再比較工具,通常比單純看GitHub Star數更有效。
本文參攷AdsPower原文的選題與組織管道,獨立核對各項目的官方GitHub倉庫、README和許可證資訊,並補充ovo Browser的公開GitHub倉庫與本地API集成說明。 項目定位、科技棧和許可證以本次核驗到的官方資料為准; Star數不作為排名依據,因為它會持續變化。
一、先弄清楚:你需要的是爬蟲、瀏覽器自動化,還是AI Agent?
- 傳統網頁抓取:頁面內容主要由服務器返回,重點是URL調度、解析規則、併發、重試和資料存儲。 可以優先看Scrapy、Colly。
- JavaScript動態頁面:需要瀏覽器執行腳本、等待元素或類比互動時,可以考慮Playwright、Puppeteer,或使用集成瀏覽器執行能力的Crawlee、Crawl4AI、Scrapling。
- AI / RAG內容採集:希望將網頁轉換成Markdown、JSON或知識庫語料,可以看Firecrawl、Crawl4AI、ScrapeGraphAI。
- 複雜網頁互動:需要Agent根據目標自行點擊、滾動和填寫表單,可以瞭解Browser Use。 它不是傳統高輸送量爬蟲的直接替代品。
二、GitHub開源爬蟲與瀏覽器自動化項目推薦
下麵按項目定位介紹10個真實存在的開源倉庫。 項目順序用於閱讀組織,不代表綜合排名。
1. Firecrawl:AI網頁採集/內容結構化
官方倉庫:https://github.com/firecrawl/firecrawl
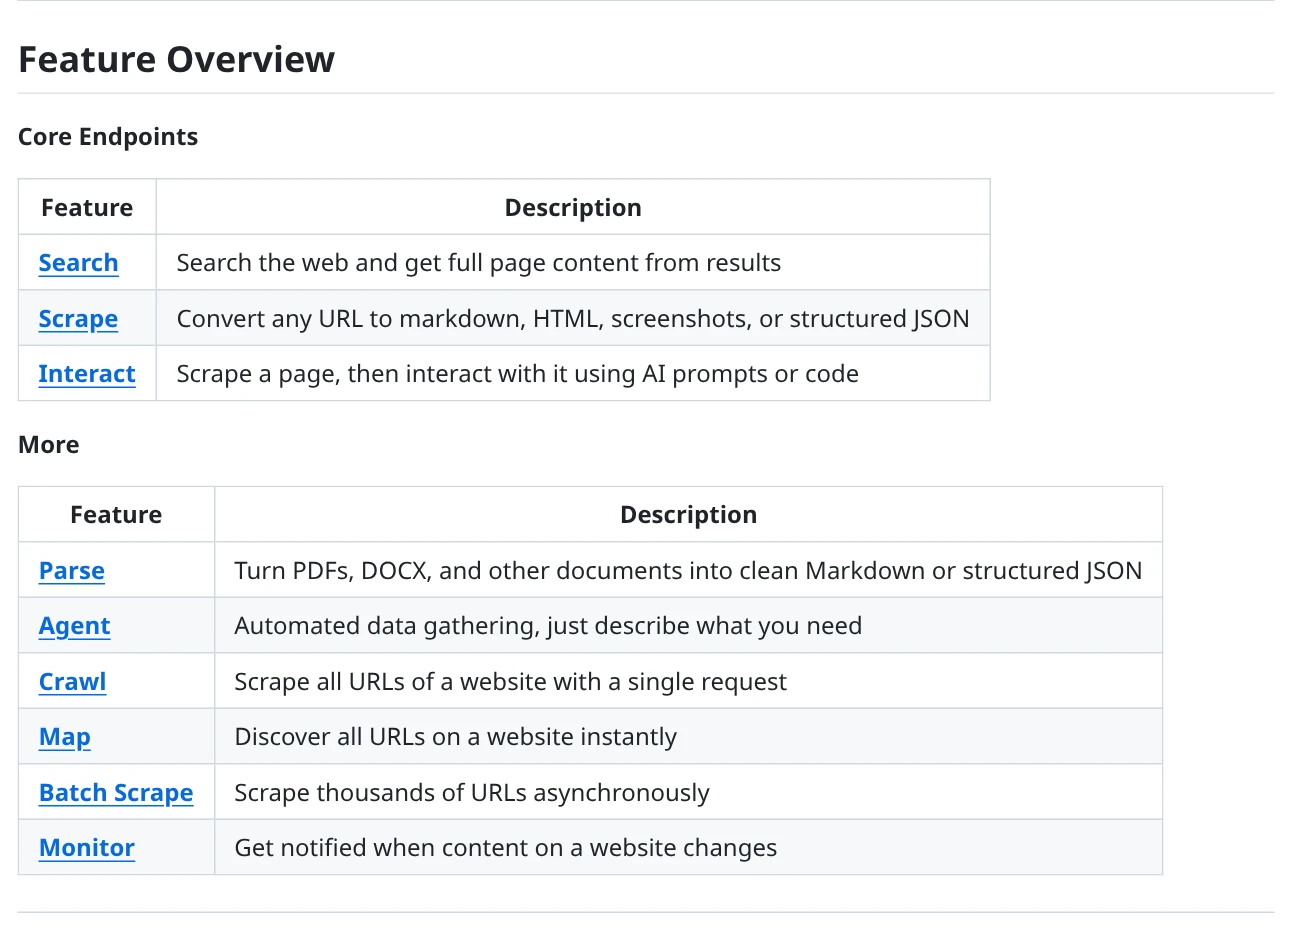
Firecrawl面向AI Agent與知識庫場景,提供Search、Scrape、Crawl、Map和Interact等能力,可將網頁內容整理為Markdown、HTML、截圖或結構化JSON,也支持對頁面執行點擊、滾動、輸入和等待等互動後再選取內容。
科技棧:TypeScript / Node.js生態 許可證:AGPL-3.0(覈心項目; 部分SDK和UI組件為MIT)
- 適合把網頁內容轉換為LLM可讀的Markdown或JSON。
- 支持單頁抓取、整站Crawl、網站URL Map與互動式頁面採集。
- 官方倉庫提供開源自託管路徑,同時也提供託管雲服務。
- 覈心項目採用AGPL-3.0,商用集成或分發前應由法務/科技團隊核對許可證義務。
- 託管雲服務包含額外能力,不能把雲端功能默認理解為本地開源版全部具備。
適合場景:適合RAG知識庫、AI Agent網頁資訊收集、檔案內容整理與網站內容建庫。
2. Crawl4AI:LLM / RAG友好型爬蟲
官方倉庫:https://github.com/unclecode/crawl4ai
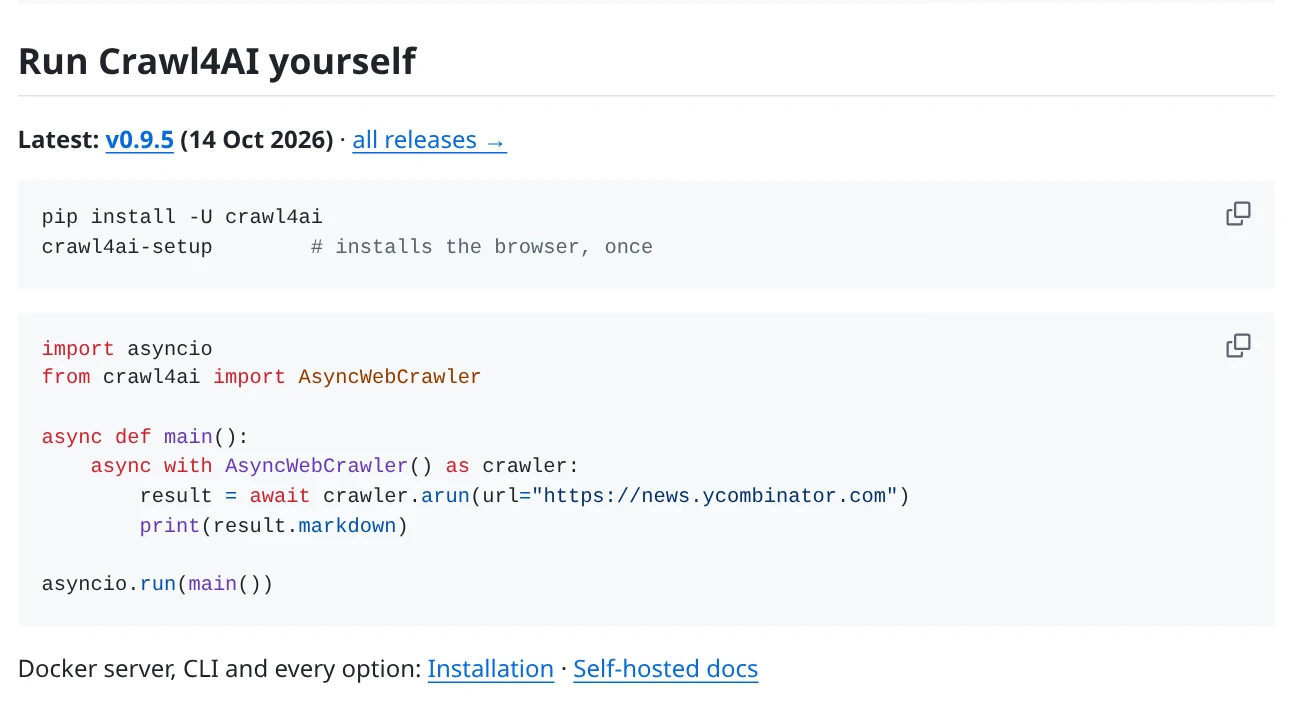
Crawl4AI是面向AI應用的開源網頁爬蟲,能够將頁面轉成結構清晰的Markdown,並通過CSS、XPath或LLM策略選取結構化數據。 官方檔案還介紹了非同步抓取、JavaScript頁面渲染、深度爬取、截圖、PDF與本地/Docker自託管管道。
科技棧:Python 許可證:Apache-2.0(官方README建議按其要求添加項目署名)
- Markdown輸出適合後續接入RAG或LLM工作流。
- 可組合傳統CSS/XPath選取與LLM結構化選取。
- 支持本地Python運行,也可按官方檔案使用Docker自託管。
- 瀏覽器、代理、運行環境和併發資源需要自行配寘與維護。
- LLM選取會涉及所選模型的資源或API成本; 不要把託管雲API的功能與本地開源庫混為一談。
- 使用時應遵循項目README的署名說明。
適合場景:適合需要將網頁資料轉為Markdown、JSON,並進一步構建知識庫或AI檢索系統的開發者。
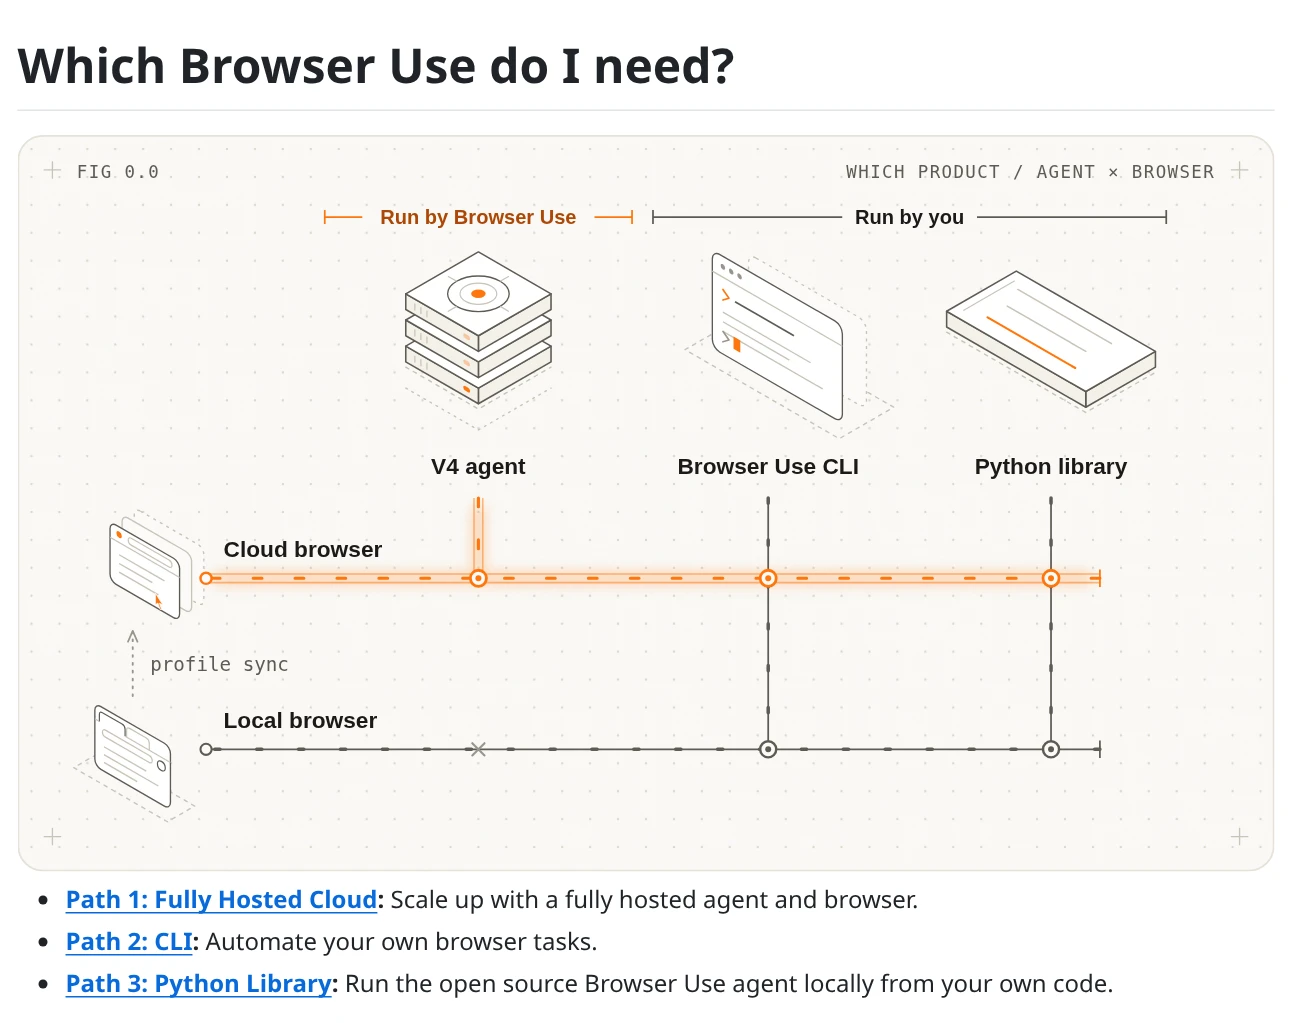
3. Browser Use:AI瀏覽器Agent
官方倉庫:https://github.com/browser-use/browser-use
Browser Use的重點不是傳統的URL隊列爬蟲,而是讓AI Agent通過瀏覽器完成多步驟網頁任務。 官方README提供本地Python Library、CLI和託管雲端等使用路徑; 本地庫可配合開發者選擇的模型和本地/雲瀏覽器運行。
科技棧:Python(並有相關TypeScript工具生態) 許可證:MIT(開源Python庫; 模型推理和託管瀏覽器服務可能另行收費)
- 適合需要點擊、滾動、填寫表單和跨頁面操作的複雜互動任務。
- 開源Python庫採用MIT許可證。
- 可按官方檔案選擇本地瀏覽器,也可使用託管瀏覽器服務。
- 它是瀏覽器Agent,不是開箱即用的高輸送量傳統爬蟲框架。
- 模型推理、協力廠商模型API或託管瀏覽器服務可能產生額外費用。
- Agent執行結果受模型、網頁變化和任務設計影響,需要人工校驗。
適合場景:適合需要瀏覽器互動的研究任務、重複網頁操作和AI Agent工作流。
4. Crawlee:生產級爬蟲框架
官方倉庫:https://github.com/apify/crawlee
Crawlee為Node.js開發者提供統一的HTTP與無頭瀏覽器抓取介面。 官方倉庫列出的能力包括持久化URL隊列、資料存儲適配、按系統資源擴展、代理輪換、會話管理、錯誤重試,以及通過Playwright或Puppeteer驅動真實瀏覽器。
科技棧:TypeScript / JavaScript(Node.js) 許可證:Apache-2.0
- 可在HTTP抓取與瀏覽器抓取之間使用統一的框架介面。
- 內寘隊列、存儲、會話、代理輪換與重試等生產工作流組件。
- 支持Playwright和Puppeteer等瀏覽器自動化工具。
- 更適合有Node.js工程能力的團隊,仍需設計數據清洗、持久化和監控。
- 生產部署需要合理配置隊列、併發、代理和網站訪問頻率。
適合場景:適合TypeScript/JavaScript團隊搭建需要任務隊列、會話管理和瀏覽器渲染的爬蟲系統。
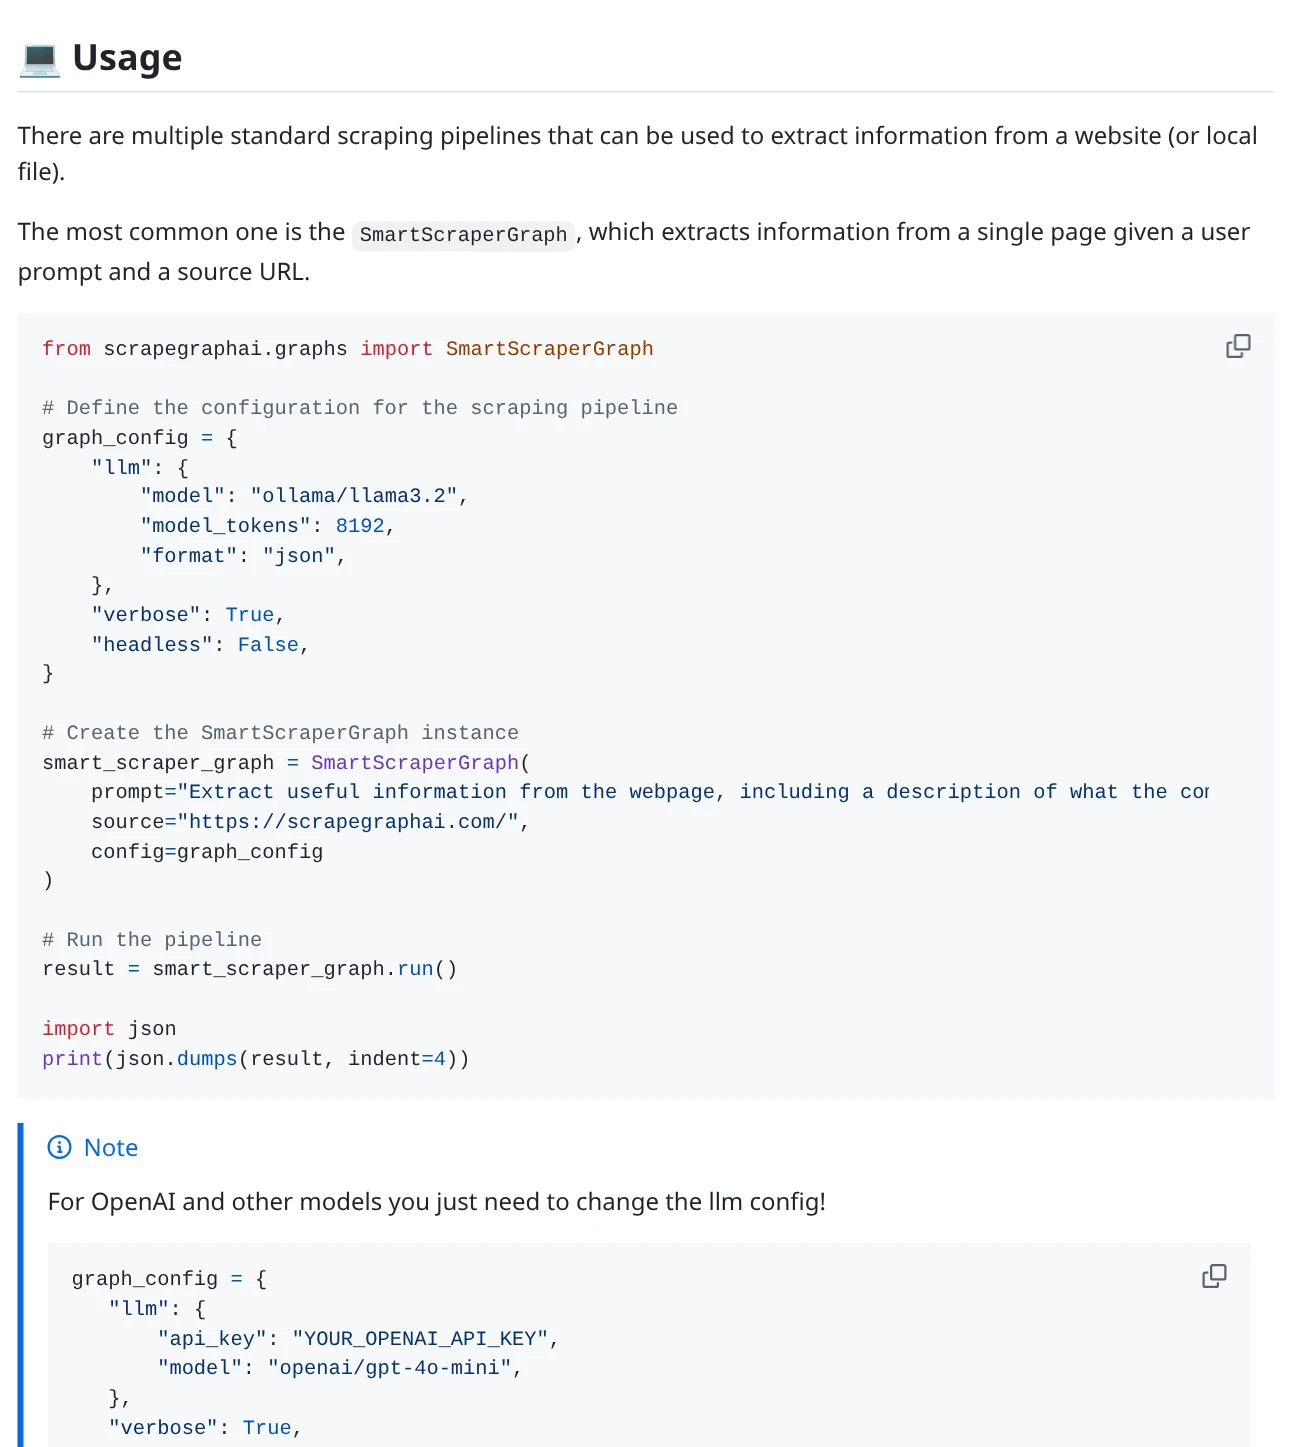
5. ScrapeGraphAI:LLM驅動的結構化選取
官方倉庫:https://github.com/ScrapeGraphAI/Scrapegraph-ai
ScrapeGraphAI使用大語言模型與圖式流程構建網頁和本地檔案的採集管線。 官方README說明它可處理網站,以及XML、HTML、JSON、Markdown等本地檔案; 開源庫與託管API在運行位置、 LLM、 瀏覽器渲染、代理和費用模型上有所區別。
科技棧:Python 許可證:MIT(開源Python庫; 託管API為獨立服務)
- 可以圍繞目標欄位描述選取任務,减少手工維護部分選擇器的工作。
- 適合將網頁與本地檔案統一納入資訊選取流程。
- 開源庫為MIT許可證,可在自有基礎設施中運行。
- 自託管開源版本需要自行配寘LLM、瀏覽器/Playwright、代理與擴展基礎設施。
- LLM輸出仍需校驗,不能默認視為完全準確的事實數據。
適合場景:適合需要把網頁或檔案轉換為特定JSON欄位,並願意自行配寘模型與運行環境的Python團隊。
6. Scrapy:成熟的Python爬蟲框架
官方倉庫:https://github.com/scrapy/scrapy
Scrapy是成熟的高層級網頁爬取與結構化數據選取框架。 官方倉庫將其定位為跨平臺的web scraping framework,適合通過Spider、請求調度和資料處理流程構建可維護的採集項目。
科技棧:Python(官方倉庫注明Python 3.11+) 許可證:BSD-3-Clause
- 適合結構清晰、規則明確、需要長期維護的網頁資料獲取項目。
- 生態成熟,適合組織Spider、請求、解析與數據輸出流程。
- BSD-3-Clause許可證,適合納入多種類型的軟件項目(仍需保留許可證要求)。
- 需要一定Python基礎,並自行設計目標網站解析規則。
- 對高度依賴前端JavaScript的頁面,通常需要額外的瀏覽器渲染方案。
適合場景:適合電商公開目錄、新聞歸檔、檔案目錄和其他結構化頁面採集。
7. Playwright:瀏覽器自動化基礎設施
官方倉庫:https://github.com/microsoft/playwright
Playwright是網頁測試與瀏覽器自動化框架,可通過統一API驅動Chromium、Firefox和WebKit。 它能處理需要JavaScript執行的頁面、表單互動、頁面等待、截圖和瀏覽器測試,但它本身不是完整的爬蟲調度與資料管理平臺。
科技棧:JavaScript / TypeScript、Python、Java、.NET等官方綁定 許可證:Apache-2.0
- 跨Chromium、Firefox、WebKit的統一瀏覽器自動化介面。
- 適合處理前端渲染、互動流程和頁面截圖。
- 可作為Crawlee等爬蟲框架的瀏覽器執行層。
- URL隊列、資料存儲、抓取調度和內容解析通常需要自行實現或搭配其他框架。
- 真實瀏覽器運行比簡單HTTP請求消耗更多資源。
適合場景:適合JavaScript渲染頁面、互動式網頁測試,以及為其他爬蟲項目提供瀏覽器執行能力。
8. Scrapling:自我調整解析與抓取
官方倉庫:https://github.com/D4Vinci/Scrapling
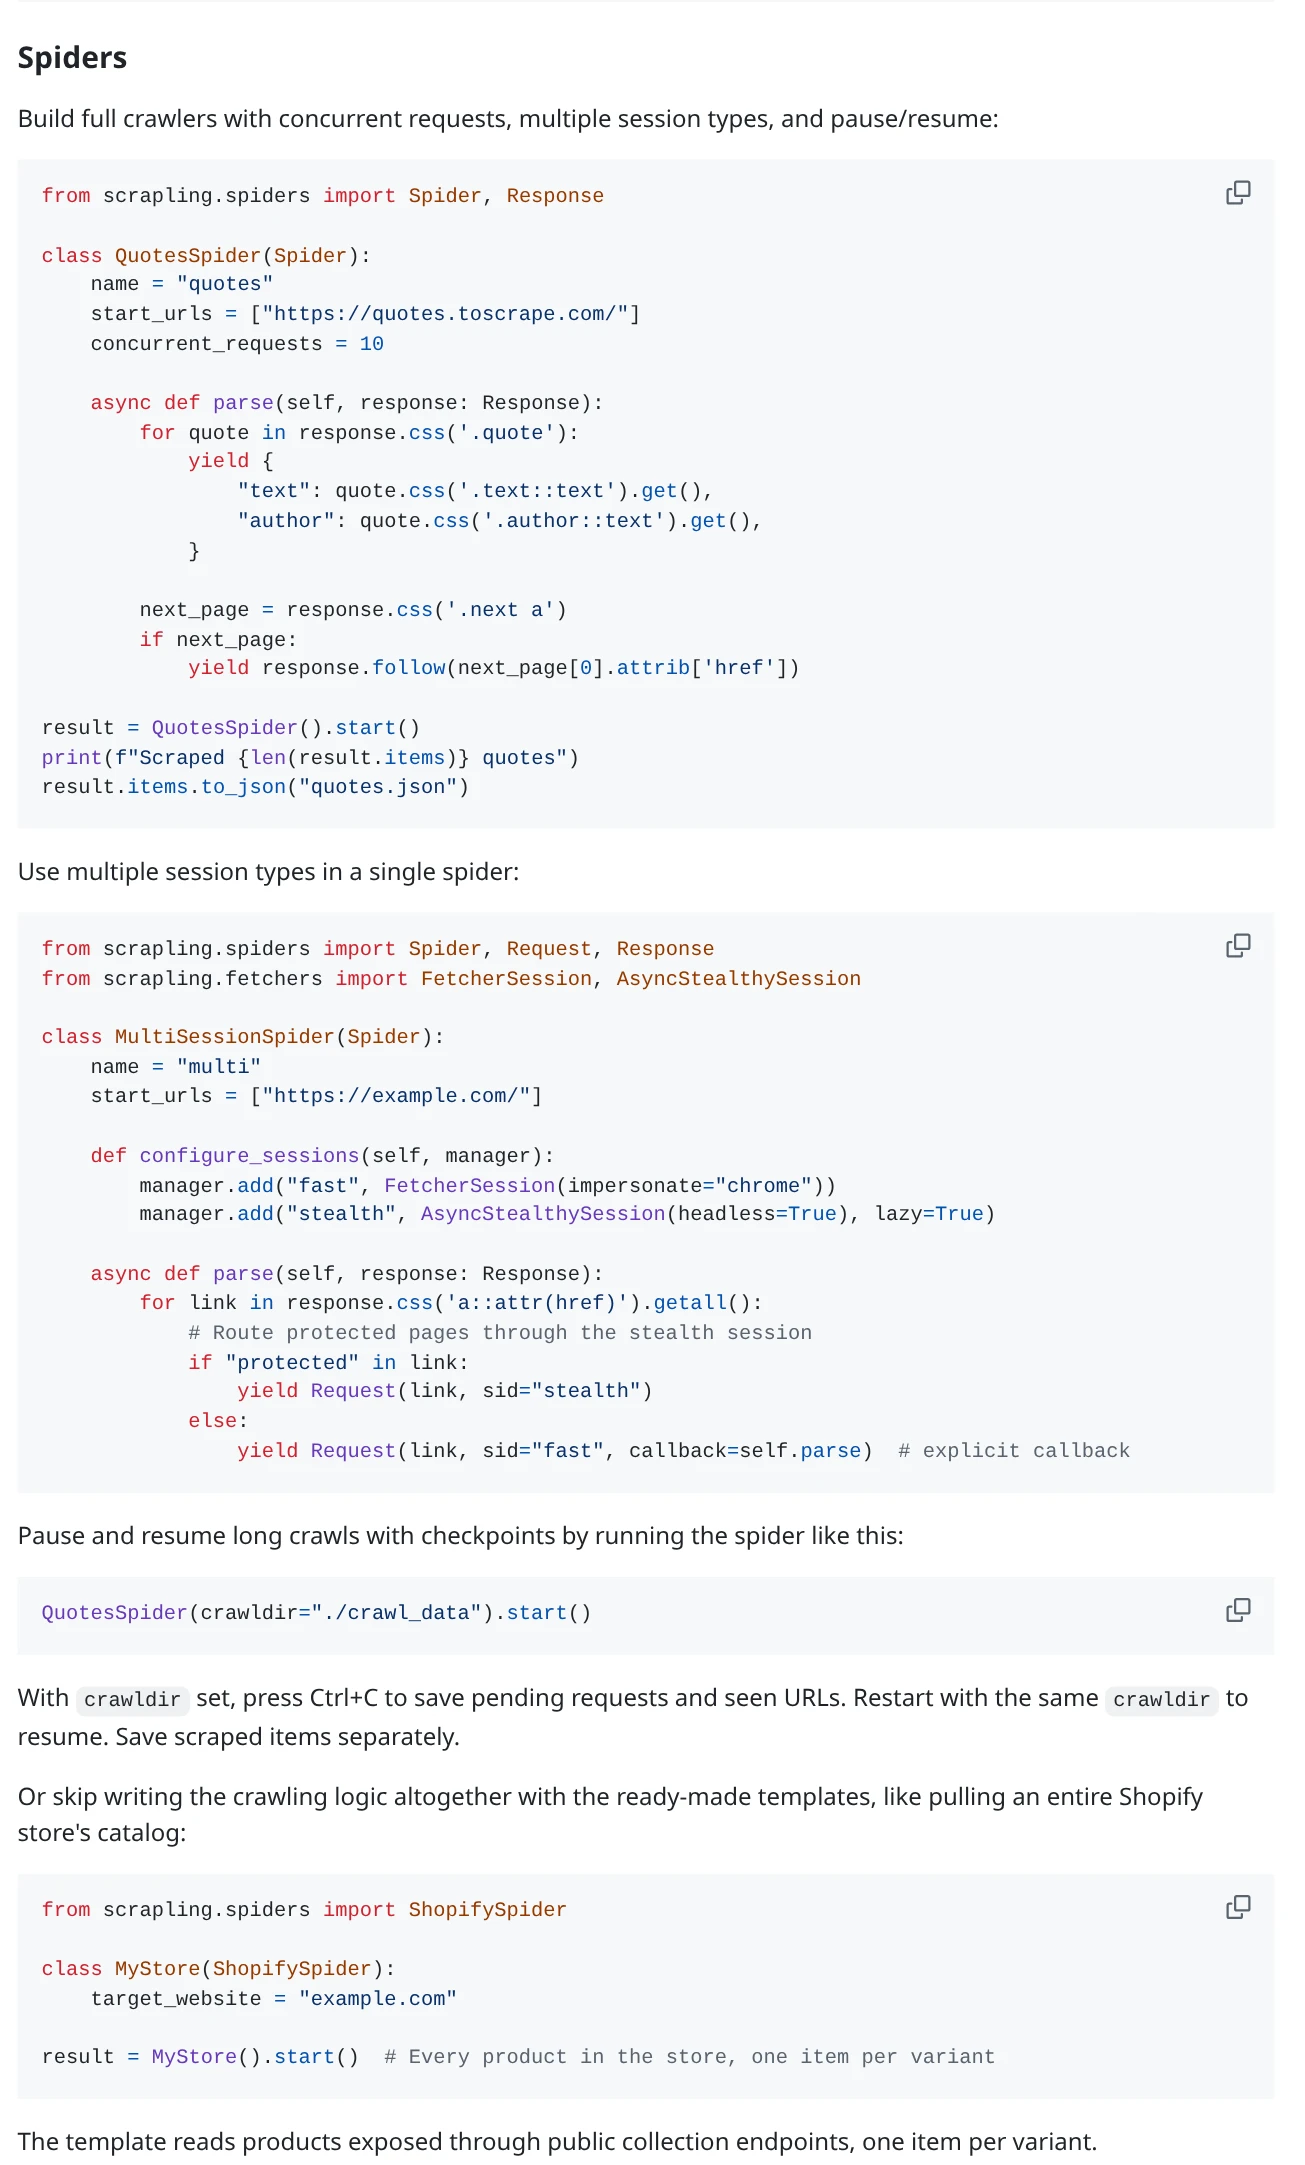
Scrapling將HTTP抓取、瀏覽器Fetcher、解析和併發Spider組織在同一套Python工具中。 其自我調整解析能力用於在頁面結構變化後重新定位元素; 官方README還列出會話管理、代理輪換、重試、暫停/恢復和JSON、JSONL、CSV、XML匯出等功能。
科技棧:Python(官方README標注Python 3.10+) 許可證:BSD-3-Clause
- 自我調整解析可以降低部分頁面DOM變化導致的選擇器維護成本。
- 可從單頁請求擴展到併發Spider。
- 提供會話、代理輪換、重試和多種數據匯出能力。
- 基礎安裝與瀏覽器Fetcher/Spider等可選依賴並不完全相同,啟用瀏覽器功能前需按官方檔案安裝extras。
- 自我調整解析不能保證所有網站改版後都無需人工維護。
適合場景:適合Python開發者處理DOM結構變化較頻繁、需要多種抓取管道的項目。
9. Puppeteer:Node.js瀏覽器控制
官方倉庫:https://github.com/puppeteer/puppeteer
Puppeteer是通過DevTools Protocol或WebDriver BiDi控制Chrome或Firefox的JavaScript庫,默認以無頭模式運行。 官方檔案列出的常見用途包括表單自動化、UI測試、頁面截圖、PDF生成,以及抓取單頁應用並生成預渲染內容。
科技棧:JavaScript / Node.js 許可證:Apache-2.0
- 對Chrome/Firefox的瀏覽器控制能力細緻。
- 適合截圖、 PDF、 表單操作和需要瀏覽器執行的頁面。
- 可與Crawlee等框架組合,補足任務調度和資料管理能力。
- 它主要負責瀏覽器控制,不提供完整的爬蟲專案管理與數據管線。
- 瀏覽器實例需要額外的CPU、記憶體和運行維護。
適合場景:適合Node.js團隊進行瀏覽器控制、頁面截圖、PDF生成和SPA內容採集。
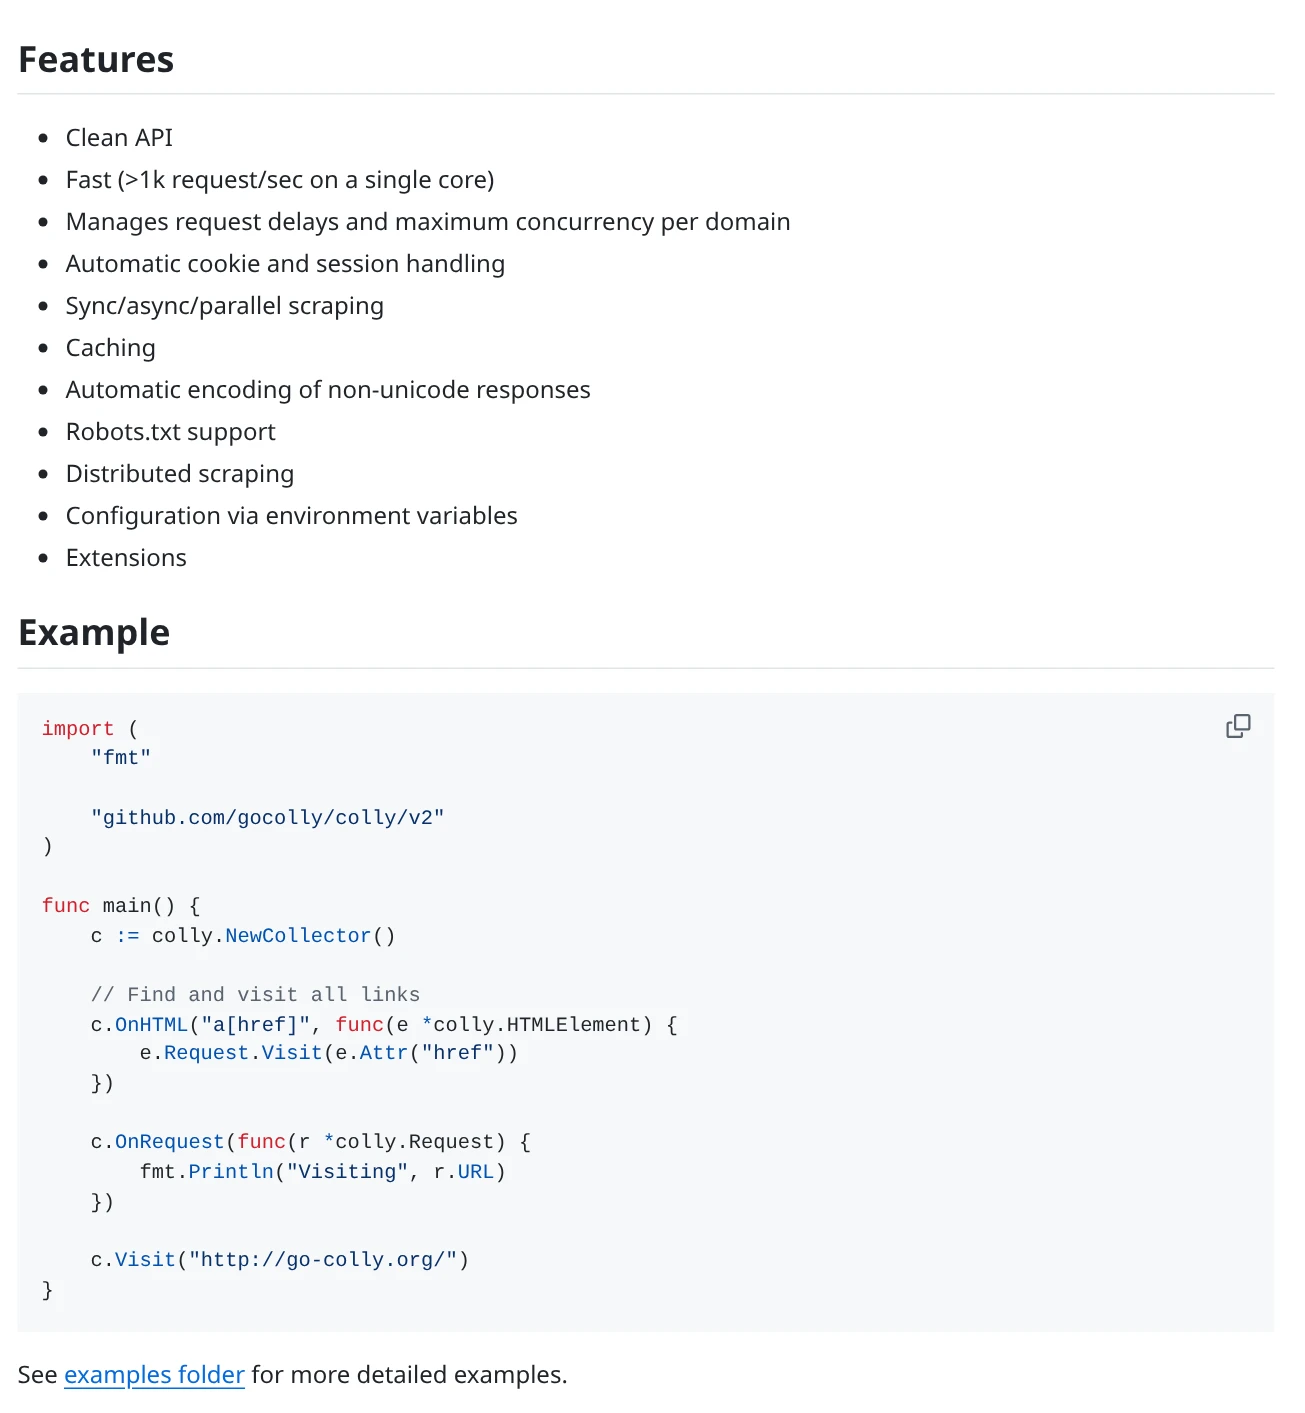
10. Colly:Go語言爬蟲框架
官方倉庫:https://github.com/gocolly/colly
Colly是Go語言的網頁爬取與數據抓取框架。 官方倉庫列出的功能包括按功能變數名稱控制請求延遲和最大併發、Cookie與會話處理、同步/非同步/並行抓取、緩存、robots.txt支持和分佈式抓取。
科技棧:Go 許可證:Apache-2.0
- 適合Go科技棧和HTTP請求型採集任務。
- 可按功能變數名稱設定延遲和併發上限,便於控制訪問節奏。
- 支持Cookie、緩存、robots.txt與分佈式抓取。
- 主要面向HTTP抓取; 需要真實瀏覽器執行JavaScript的頁面應考慮瀏覽器自動化工具。
- 需要Go開發能力和自行設計數據輸出、監控與任務部署。
適合場景:適合Go團隊採集結構相對穩定的公開網頁、目錄和網站內容。
三、10個項目怎麼選? 一張錶快速對比
| 項目 | 主要定位 | 語言/科技棧 | 許可證 | 優先考慮的場景 |
|---|---|---|---|---|
| Firecrawl | 網頁搜索、抓取與內容結構化 | TypeScript / Node.js生態 | AGPL-3.0(覈心) | AI / RAG語料採集 |
| Crawl4AI | LLM友好型非同步爬蟲 | Python | Apache-2.0 | 網頁轉Markdown / JSON |
| Browser Use | AI瀏覽器Agent | Python | MIT(開源庫) | 多步驟互動任務 |
| Crawlee | 生產級爬蟲框架 | TypeScript / JavaScript | Apache-2.0 | 隊列、會話和瀏覽器抓取 |
| ScrapeGraphAI | LLM圖式選取 | Python | MIT(開源庫) | 按欄位選取網頁與檔案 |
| Scrapy | 結構化網頁抓取 | Python | BSD-3-Clause | 長期維護的採集項目 |
| Playwright | 瀏覽器自動化/測試 | 多語言綁定 | Apache-2.0 | 動態頁面與互動 |
| Scrapling | 自我調整解析與併發抓取 | Python | BSD-3-Clause | 頁面結構變化較多 |
| Puppeteer | Chrome / Firefox控制 | JavaScript / Node.js | Apache-2.0 | 截圖、PDF、SPA頁面 |
| Colly | Go HTTP抓取框架 | Go | Apache-2.0 | Go科技棧和併發請求 |
簡單選型建議:如果主要抓取結構化網頁,可先從Scrapy或Colly入手; 如果頁面需要瀏覽器執行JavaScript,優先評估Playwright或Puppeteer; 如果項目要把網頁轉成AI語料,可對比Firecrawl、Crawl4AI和ScrapeGraphAI; 如果需要Agent執行多步驟操作,再看Browser Use。
四、延伸推薦:ovo Browser官方GitHub項目與自動化能力
上面10個項目主要負責“如何發現頁面、讀取內容、解析欄位或執行網頁互動”。 當一個團隊還需要管理不同瀏覽器工作環境、代理配寘和自動化瀏覽器行程時,就需要考慮瀏覽器運行環境這一層。
ovo Browser的定位是瀏覽器環境管理與自動化銜接,不是爬蟲框架。 它不會替代Scrapy、Crawlee或Firecrawl的抓取調度、內容解析和資料存儲功能; 它可以作為瀏覽器環境與自動化工具之間的一層連接。
1. ovo Browser Chromium內核倉庫
官方公開倉庫:ovobrowsersupport/ovobrowser。
該倉庫README將其定位為源碼級修改的Chromium指紋內核,並提供Windows x64便攜包與開發者示例。 倉庫說明列出Canvas、WebGL、Audio、ClientRects、Font等相關配寘項,以及Python、Node.js、Go、C#、PowerShell、Java、Rust等語言的啟動示例。 倉庫頁面標注MIT許可證。
需要區分:這個倉庫面向開發者,包含內核便攜包說明和啟動示例; 它不是一個網頁爬蟲框架,也不等於ovo Browser圖形化用戶端的全部源碼。
2. ovo Browser圖形化用戶端介紹倉庫
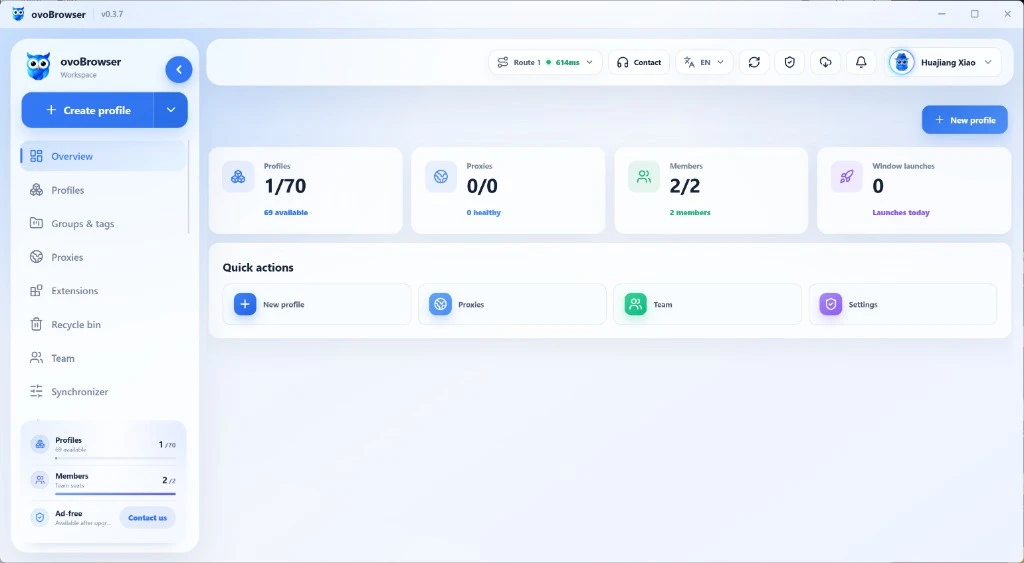
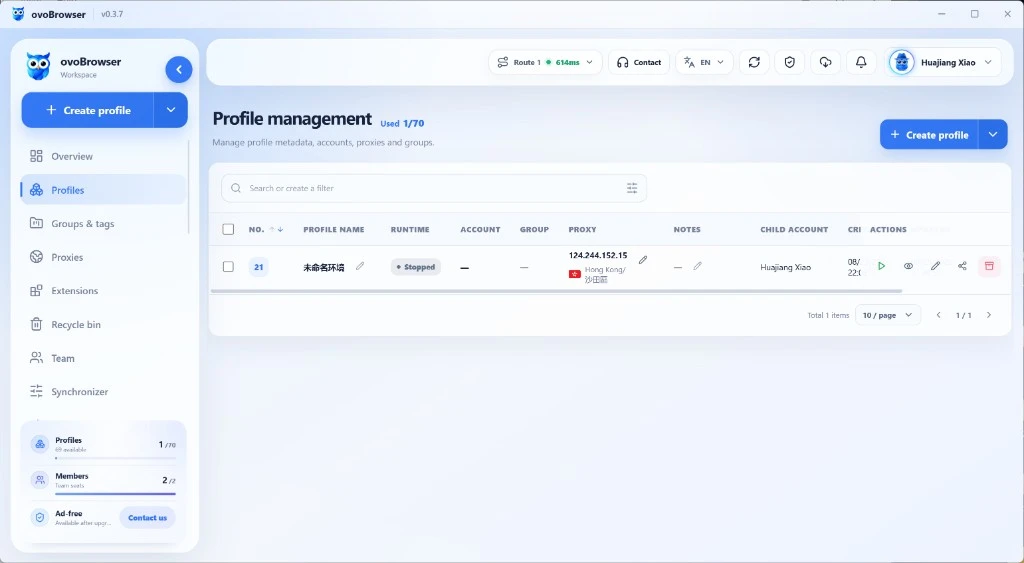
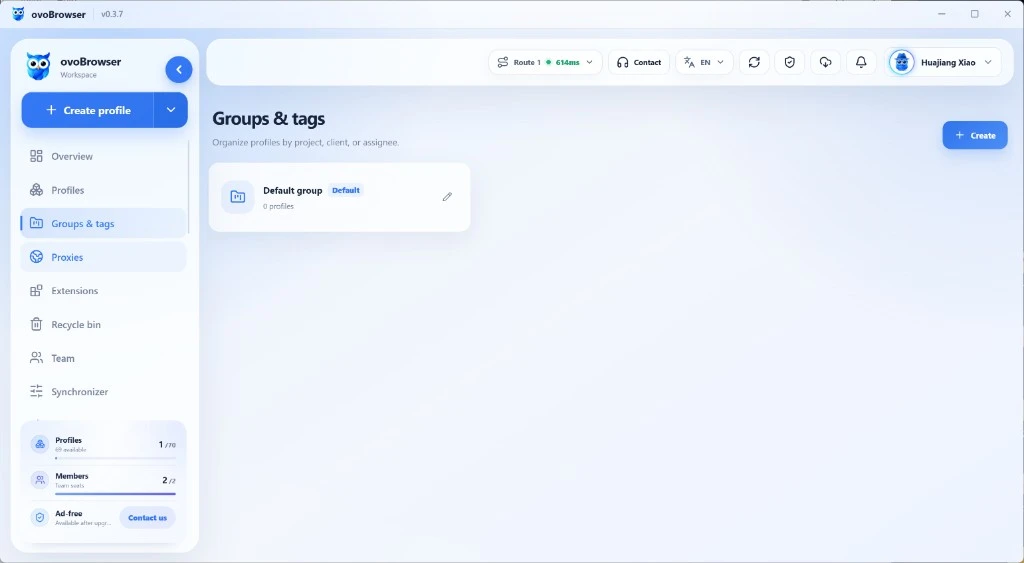
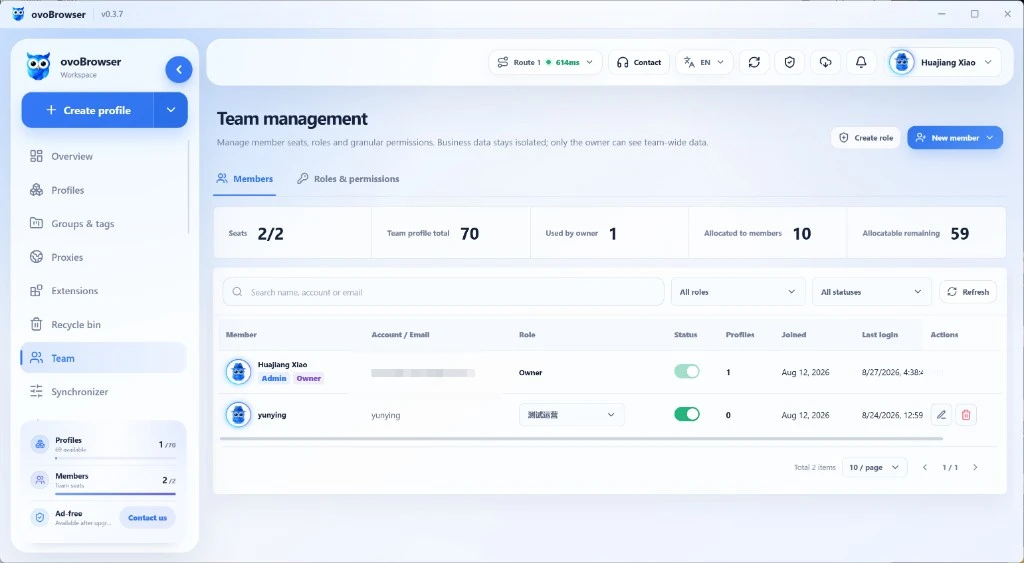
官方公開倉庫:ovobrowsersupport/ovobrowser-manger。該倉庫README將其描述為面向普通用戶的案頭用戶端介紹與截圖資料,說明可在圖形介面中管理瀏覽器環境、代理、團隊和視窗同步。
README中標注的用戶端截圖版本為v0.3.7。 下方圖片來自該官方倉庫的docs/assets目錄,屬於真實產品截圖; 如果發佈時用戶端介面已經更新,應替換為當前版本截圖,並在圖注中標明版本。
3. ovo Browser本地API:讓自動化工具連接瀏覽器環境
ovo Browser官方本地API檔案說明,本地HTTP API可管理瀏覽器環境、分組、標籤、代理、回收站和瀏覽器行程。 介面採用POST + JSON Body; 檔案列出的介面包括環境清單、創建/更新環境、代理管理,以及打開、査詢和關閉瀏覽器環境。
打開環境後,API響應會返回 pid、ws、http 等資訊; 官方檔案明確說明,返回的 ws 可以交給Playwright或Puppeteer使用。 這為把ovo Browser的環境管理與現有瀏覽器自動化程式碼連接起來提供了入口。
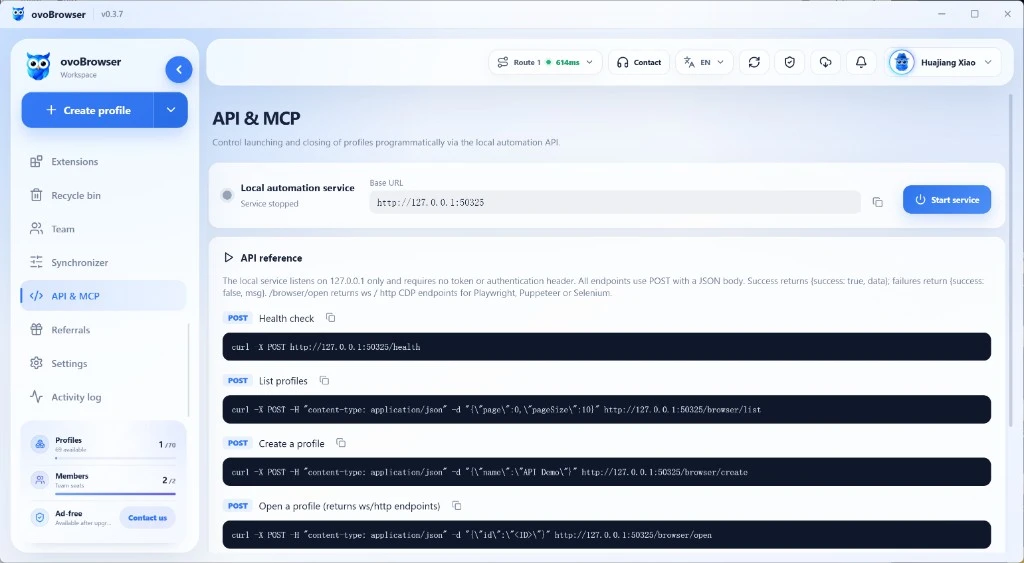
官方檔案中的打開環境請求示例:
curl --location 'http://127.0.0.1:50325/browser/open' \
  --header 'Content-Type: application/json' \
  --data '{"id":"YOUR_PROFILE_ID","headless":false}'
請求成功後,響應會包含行程與瀏覽器連接資訊。 開發者可按官方檔案將返回的 ws 提供給Playwright或Puppeteer; 具體連接程式碼應以你當前用戶端版本與官方API檔案為准。
4.一個更清晰的ovo Browser +開源爬蟲工作流
- 選擇採集框架:按任務選擇Scrapy、Crawlee、Crawl4AI,或用Playwright / Puppeteer處理需要瀏覽器執行的頁面。
- 建立瀏覽器環境:在ovo Browser中按項目創建和命名環境,按實際網絡需要配寘代理。
- 通過本地API打開環境:使用本地API打開指定環境,讀取響應中的瀏覽器連接資訊。
- 連接自動化工具:根據官方檔案將連接資訊交給Playwright或Puppeteer,由開發者編寫頁面訪問、等待、選取和保存邏輯。
- 管理數據與訪問節奏:將採集結果保存到自己的資料庫或檔案中,並設定合理的併發、延遲和失敗重試。
5.使用ovo Browser本地API時的安全注意事項
ovo Browser官方API檔案說明,本地API只監聽 127.0.0.1,並且不要求Token、Bearer Token或 x-api-key。囙此,應保持服務僅在本機使用,不要將本地API埠暴露到公網或不可信局域網。 官方檔案也提醒,帳號、Cookie、2FA金鑰和代理密碼屬於敏感資訊,不要寫入公共日誌。
另外,瀏覽器環境隔離和代理配寘並不意味著可以繞過目標網站的存取控制。 開發者應遵守目標網站的服務條款、 robots.txt、 隱私要求、版權規則和適用法律; 對需要登入、付費、個人數據或明確禁止自動化訪問的內容,應先取得適當授權。
五、常見問題
GitHub開源爬蟲項目是不是完全免費?
開源許可證允許用戶在相應條件下使用、修改或分發程式碼,但不代表運行成本為零。 服務器、代理、瀏覽器運行資源、LLM API和託管雲服務都可能產生費用; AGPL、Apache、MIT、BSD等許可證的義務也不同,商用前應查看項目根目錄中的LICENSE檔案。
Scrapy、Playwright和Firecrawl應該怎麼選?
Scrapy更適合傳統結構化網頁採集; Playwright是瀏覽器自動化和測試框架,適合處理JavaScript渲染與頁面互動; Firecrawl面向網頁內容抓取、蒐索和結構化輸出,尤其適合AI / RAG工作流。 三者解决的問題不同,也可以在同一系統中組合使用。
ovo Browser本身是爬蟲軟件嗎?
不是。 ovo Browser主要用於管理瀏覽器環境、代理和自動化連接。 實際的URL調度、網頁解析、數據清洗、資料庫寫入等任務,仍需由Scrapy、Crawlee、Firecrawl或開發者自己的程式碼完成。
ovo Browser能不能連接Playwright或Puppeteer?
ovo Browser官方用戶端說明和本地API檔案均介紹了與Playwright、Puppeteer的銜接管道。 官方API在打開環境後返回瀏覽器連接資訊,其中 ws 可交給Playwright或Puppeteer。 具體實現請以當前版本檔案為准。
使用爬蟲項目就能保證不被網站限制嗎?
不能。 任何框架或瀏覽器配寘都無法保證目標網站始終允許自動化訪問。 應遵循目標網站規則,設定合理訪問頻率; 遇到拒絕訪問、驗證碼、登入牆或訪問限制時,不要嘗試規避未經授權的存取控制。
結語:先選對工具,再搭建穩定、合規的工作流
GitHub上的開源爬蟲生態已經覆蓋從簡單HTTP抓取到瀏覽器自動化、AI結構化選取的多個層次。 Scrapy和Colly適合傳統採集,Crawlee適合構建帶隊列與會話管理的項目,Playwright和Puppeteer負責瀏覽器控制,Firecrawl、Crawl4AI、ScrapeGraphAI則適合網頁內容進入AI工作流。
如果項目還需要獨立管理瀏覽器環境,並將環境連接到現有自動化程式,可以進一步瞭解ovo Browser的官方GitHub內核倉庫與本地API。 讓每個工具負責自己擅長的部分,往往比期待單一軟件完成所有工作更可靠。
訪問ovo Browser官網,瞭解瀏覽器環境管理與自動化能力
參考資料與官方來源
相關文章
2026 Facebook主頁增長指南
對跨境電商、海外品牌和社媒運營團隊來說,Facebook主頁增長不是簡單地新增發帖數量,而是持續提供有價值的原創內容、建立清晰的品牌定位、及時回應受眾,並根據數據調整內容方向。 本文從主頁準備、內容規劃、30天運營節奏、團隊合作和數據複盤講起,並介紹ovo Browser如何幫助團隊把多個已獲授權的業務環境管理得更清楚。
閱讀文章
ovo Browser、GoLogin和AdsPower怎麼選?
免費版、自動化、價格全面對比
閱讀文章
Claude帳號為什麼會觸發驗證、警告或限制?
本文沿著“帳號狀態—地區與網絡—支付驗證—使用行為—設備與會話—環境管理”的順序,梳理值得檢查的環節,並介紹ovo Browser如何幫助用戶整理瀏覽器工作環境。
閱讀文章