 ovobrowser
Перейти к разделу статьи
Проект GitHub с открытым исходным кодом для рептилий: 10 инструментов, которые стоит собрать вместе с руководством по автоматизации ovo Browser
От сбора веб - страниц AI, традиционных рептилий, автоматизации браузера до параллельного сканирования Go, проведите инвентаризацию 10 реальных проектов с открытым исходным кодом GitHub, проверьте использование проекта, технологический стек и протокол с открытым исходным кодом, а также опишите, как официальный склад GitHub ovo Browser и локальный API связаны с такими инструментами, как Playwright и Puppeteer, чтобы помочь разработчикам создать более четкий и поддерживаемый рабочий процесс для веб - данных.
Чтобы создать веб - систему сбора данных, не обязательно быть рептилией с нуля. На GitHub уже есть множество зрелых проектов с открытым исходным кодом, которые охватывают различные аспекты, такие как традиционный HTTP - захват, рендеринг страниц JavaScript, автоматизация браузера, извлечение контента ИИ и одновременное планирование задач.
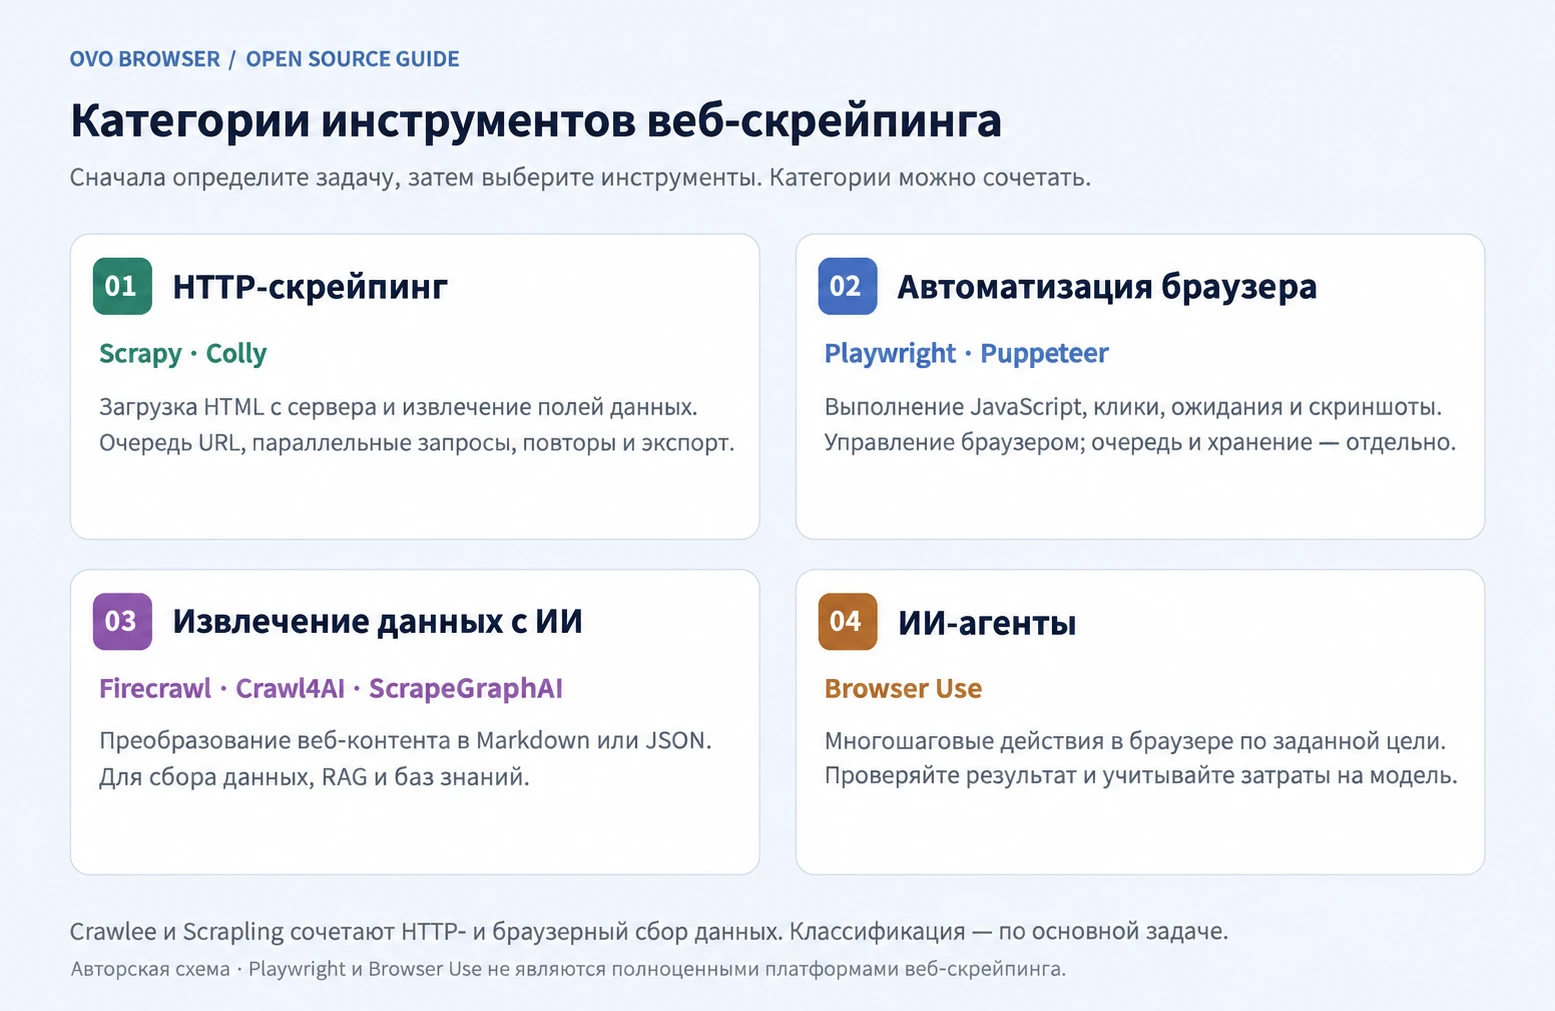
Но « Проект рептилии» не является одной категорией: Scrapy, Colly более склонны к рамкам сбора; Playwright и Puppeteer отвечают за управление браузером; Browser Use Многоэтапные веб - операции для AI Agent; В Firecrawl, Crawl4AI и ScrapeGraphAI больше внимания уделяется структурированию веб - контента и рабочим процессам ИИ. Подтверждение задач при выборе и сравнение инструментов обычно более эффективны, чем просто просмотр чисел GitHub Star.
В этой статье рассматриваются темы и организация оригинального текста AdsPower, проводится независимая проверка официальной информации о складах GitHub, README и лицензиях для каждого проекта, а также дополняются инструкции ovo Browser по интеграции открытого хранилища GitHub с локальным API. Местоположение проекта, технические стеки и лицензии основаны на официальной информации, полученной в ходе настоящей проверки; Число звезд не является основанием для ранжирования, поскольку оно постоянно меняется.
Во - первых, выясните: вам нужны рептилии, автоматизация браузера или AI Agent?
- Традиционный веб - сканер:Содержание страницы в основном возвращается сервером с акцентом на планирование URL - адресов, правила интерпретации, параллельное воспроизведение, повторную отладку и хранение данных. Приоритет отдается Scrapy и Colly.
- Динамическая страница JavaScript:При необходимости выполнения скрипта браузера, ожидания элементов или моделирования взаимодействия можно рассмотреть Playwright, Puppeteer или Crawlee, Crawl4AI, Scrapling, которые используют встроенные возможности выполнения браузера.
- Сбор контента AI / RAG:Если вы хотите преобразовать веб - страницы в Markdown, JSON или базы знаний, посмотрите Firecrawl, Crawl4AI, ScrapeGraphAI.
- Сложные веб - взаимодействия:Агент должен щелкнуть, прокрутить и заполнить форму в соответствии с целью, чтобы узнать об использовании Browser. Это не прямая замена традиционным рептилиям с высокой пропускной способностью.
Проект GitHub с открытым исходным кодом для рептилий и автоматизации браузера
Ниже представлены 10 реальных хранилищ с открытым исходным кодом в соответствии с позиционированием проекта. Порядок проектов используется для чтения организаций и не представляет собой сводный рейтинг.
Firecrawl: сбор веб - страниц ИИ / структурирование контента
Официальный склад:https://github.com/firecrawl/firecrawl
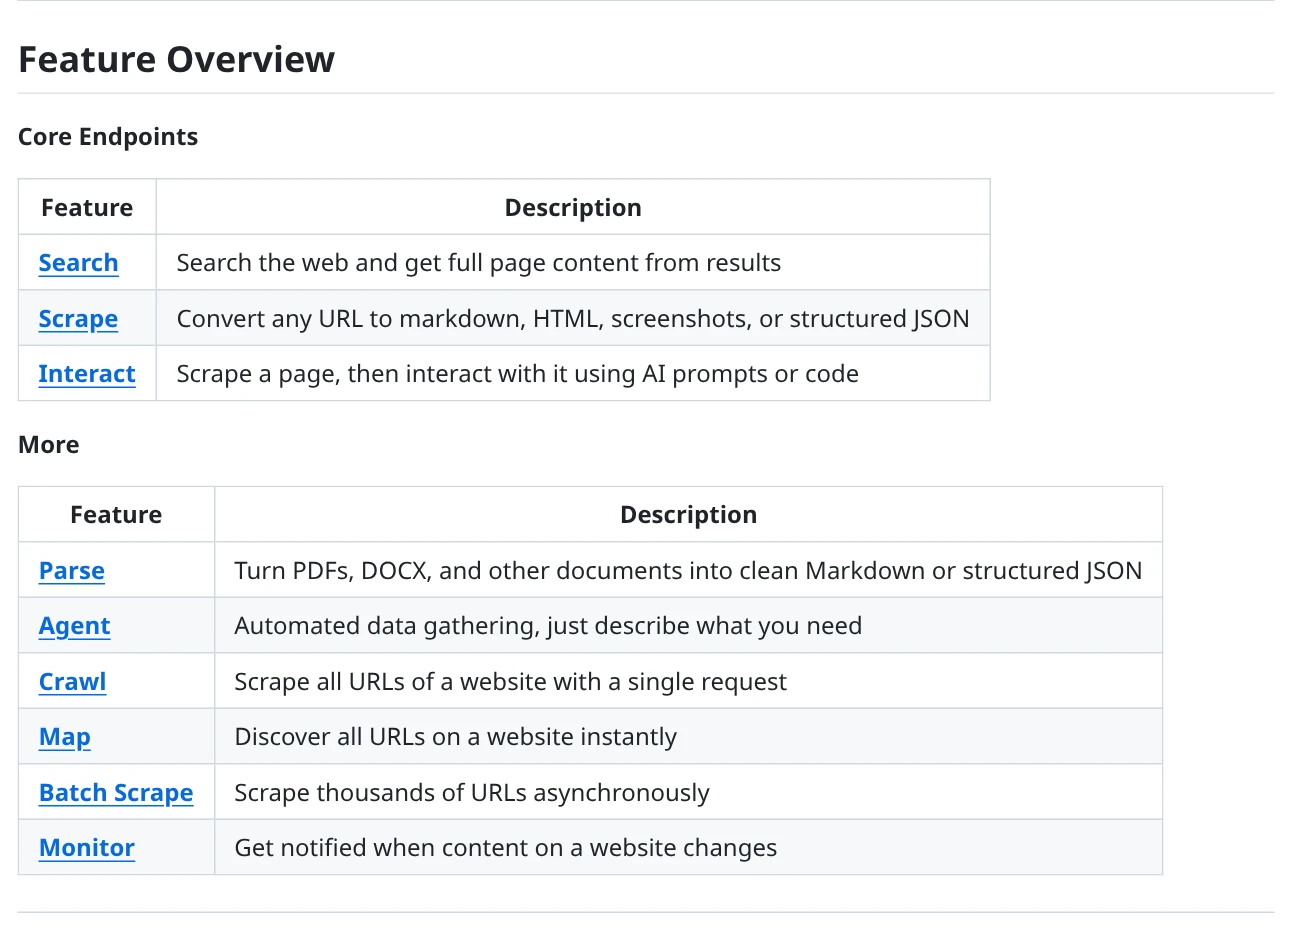
Firecrawl ориентирован на AI Agent и сценарии базы знаний, предлагает возможности поиска, Scrape, Crawl, Map и Interact, организует содержимое веб - страниц в виде Markdown, HTML, скриншотов или структурированных JSON, а также поддерживает интерактивное извлечение содержимого после нажатия на страницу, прокрутки, ввода и ожидания.
Технический стек:TypeScript / Node.js Экология Лицензия:AGPL - 3.0 (Основные проекты; Некоторые компоненты SDK и UI являются MIT)
- Подходит для преобразования веб - контента в LLM читаемый Markdown или JSON.
- Поддерживаются сканирование одной страницы, вся станция Crawl, URL - карта сайта и интерактивный сбор страниц.
- Официальные склады предлагают открытый путь хостинга, а также управляемые облачные сервисы.
- Основные проекты используют AGPL - 3.0, и до коммерческой интеграции или распространения лицензионные обязательства проверяются юридической / технической командой.
- Облачные сервисы хостинга содержат дополнительные возможности, которые по умолчанию не могут быть истолкованы как полностью доступные для локальных версий с открытым исходным кодом.
Подходит для сцены:Подходит для баз знаний RAG, сбора информации о веб - страницах AI Agent, сортировки содержимого документов и создания контента сайта.
Crawl4AI: LLM / RAG Дружелюбные рептилии
Официальный склад:https://github.com/unclecode/crawl4ai
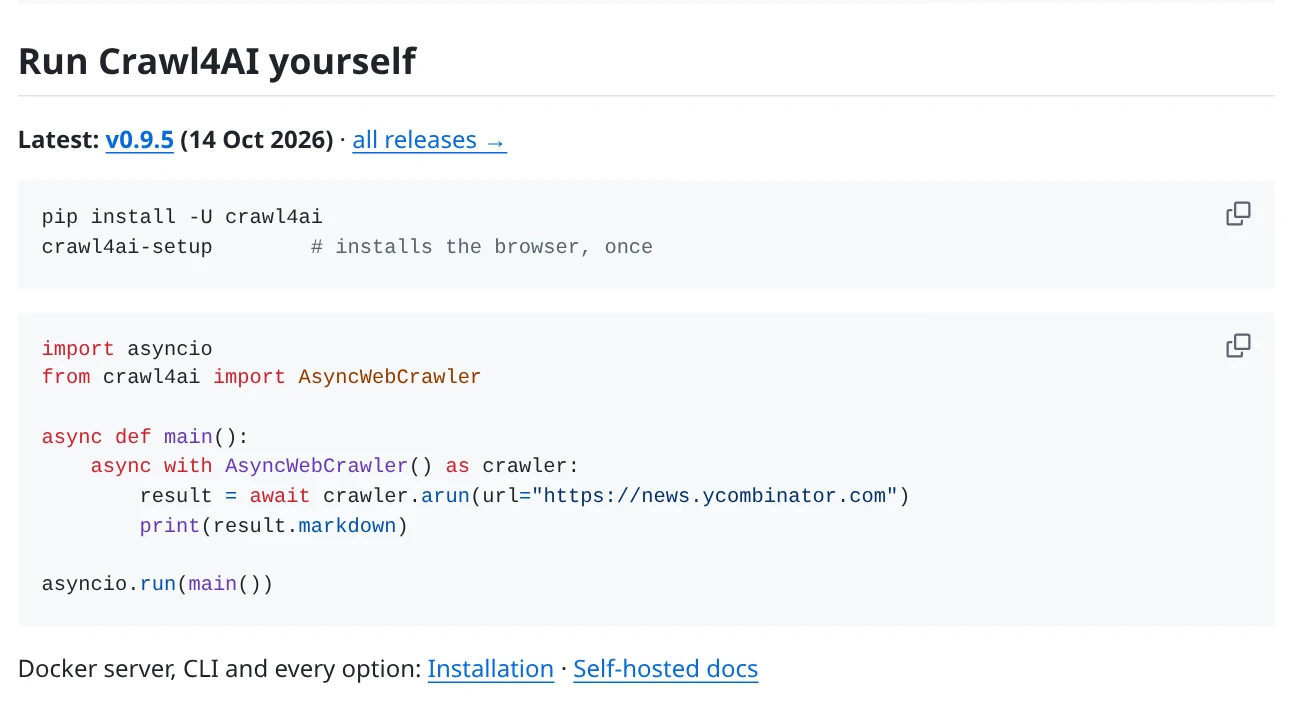
Crawl4AI - это веб - рептилия с открытым исходным кодом для приложений ИИ, которая преобразует страницы в структурированные Markdown и извлекает структурированные данные с помощью стратегий CSS, XPath или LLM. В официальных документах также описаны асинхронный захват, рендеринг страниц на JavaScript, глубокое восхождение, скриншоты, PDF и локальный / Docker способ самохостинга.
Технический стек:Python Лицензия:Apache - 2.0 (официальное README предлагает добавить подпись проекта по требованию)
- Выход Markdown подходит для последующего подключения к рабочим процессам RAG или LLM.
- Можно комбинировать традиционную экстракцию CSS / XPath с структурированной экстракцией LLM.
- Поддержка локальной работы Python, а также использование Docker в официальных документах.
- Браузеры, прокси - серверы, операционная среда и параллельные ресурсы должны быть настроены и обслуживаться самостоятельно.
- Извлечение LLM связано с затратами на ресурсы или API выбранной модели; Не путайте функции управляемого облачного API с локальной библиотекой с открытым исходным кодом.
- При использовании следует руководствоваться подписанным описанием проекта README.
Подходит для сцены:Подходит для разработчиков, которым необходимо преобразовать веб - материалы в Markdown, JSON и создать базу знаний или систему поиска ИИ.
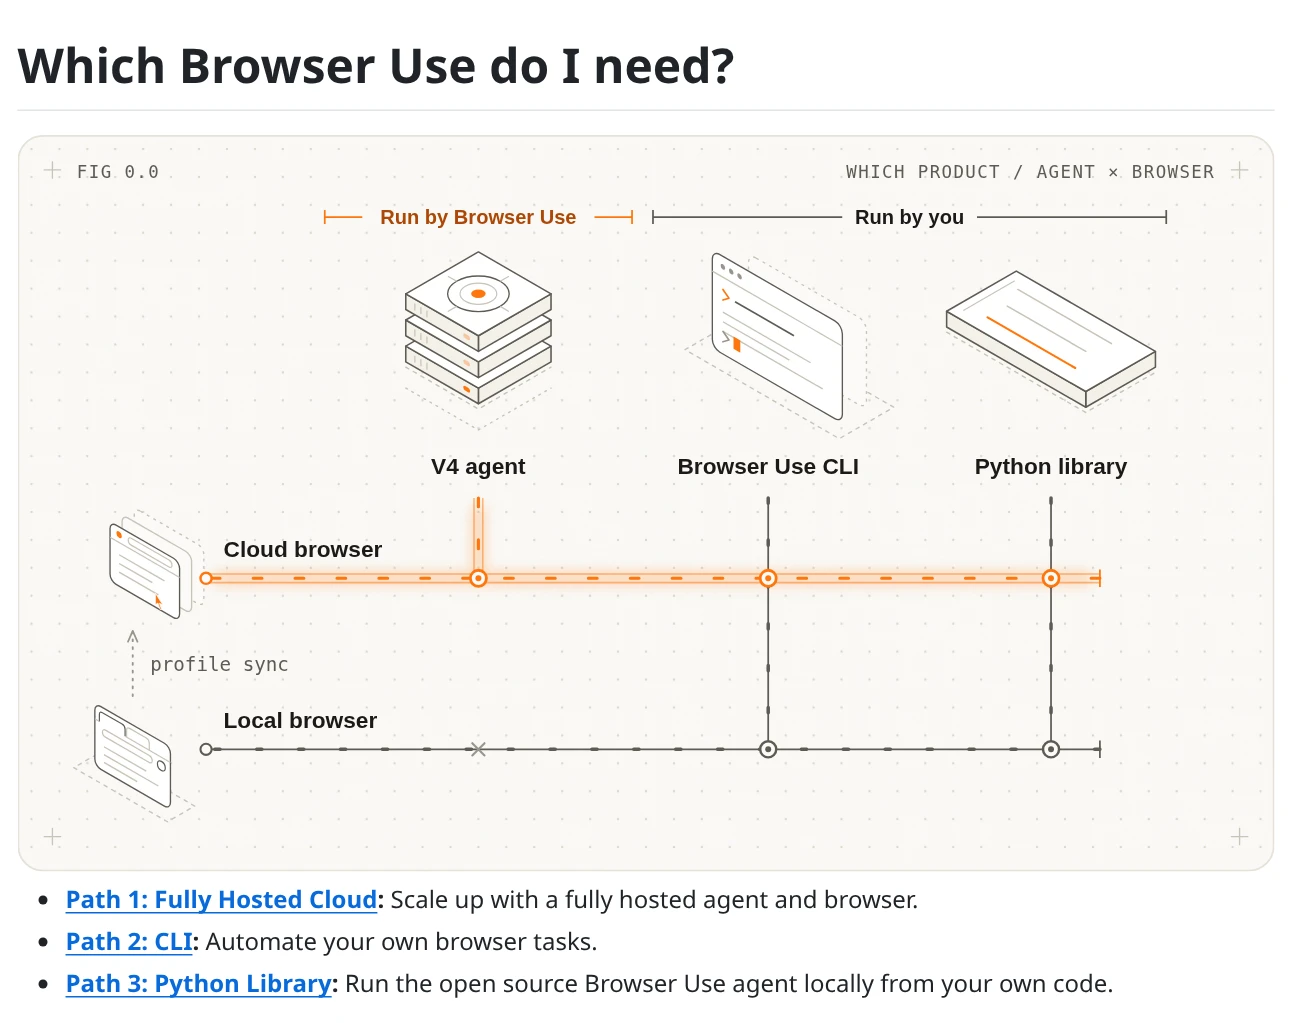
Browser Use: Агент браузера Agent
Официальный склад:https://github.com/browser-use/browser-use
Вместо традиционного рептилия URL - очереди, Browser Use фокусируется на том, чтобы позволить AI Agent выполнять многоэтапные веб - задачи через браузер. Официальный README предоставляет доступ к локальной библиотеке Python, CLI и управляемому облаку; Локальная библиотека может работать с выбранной разработчиком моделью и локальным / облачным браузером.
Технический стек:Python (с сопутствующей экосистемой инструментов TypeScript) Лицензия:MIT (библиотека Python с открытым исходным кодом; Услуги моделирования и хостинга браузеров могут быть платными отдельно)
- Подходит для сложных интерактивных задач, требующих щелчка, прокрутки, заполнения форм и кросс - страниц.
- Библиотека Python с открытым исходным кодом использует лицензию MIT.
- Можно выбрать локальный браузер по официальному документу или воспользоваться услугами управляемого браузера.
- Это браузерный агент, а не обычная рептилоидная рамка с высокой пропускной способностью, используемая в открытом ящике.
- Модельные рассуждения, сторонние модели API или хостинг - браузеры могут повлечь за собой дополнительные расходы.
- Результаты выполнения Agent зависят от моделей, веб - изменений и дизайна задач и требуют ручной проверки.
Подходит для сцены:Подходит для исследовательских задач, требующих взаимодействия браузера, повторяющихся веб - операций и рабочих процессов AI Agent.
4. Crawlee: рамки для рептилий производственного уровня
Официальный склад:https://github.com/apify/crawlee
Crawlee предоставляет разработчикам Node.js единый HTTP - интерфейс с безголовым браузером. Возможности, перечисленные в официальном хранилище, включают в себя устойчивую очередь URL - адресов, адаптацию хранилища данных, расширение по системным ресурсам, ротацию прокси - серверов, управление сеансами, повторное тестирование ошибок и драйв реального браузера через Playwright или Puppeteer.
Технический стек:TypeScript / JavaScript(Node.js) Лицензия:Apache-2.0
- Можно использовать единый рамочный интерфейс между HTTP - сканированием и браузерным сканированием.
- Встроенные очереди, хранение, сеансы, ротация прокси - серверов и повторные испытания и другие компоненты производственного рабочего процесса.
- Поддержка инструментов автоматизации браузеров, таких как Playwright и Puppeteer.
- Идеально подходит для команд с инженерными возможностями Node.js, которые по - прежнему должны проектировать очистку данных, долговечность и мониторинг.
- Производственное развертывание требует разумной конфигурации очередей, параллельных, прокси - серверов и частоты доступа к сайту.
Подходит для сцены:Подходит для команд TypeScript / JavaScript для создания рептилий, требующих очереди задач, управления сеансами и рендеринга браузера.
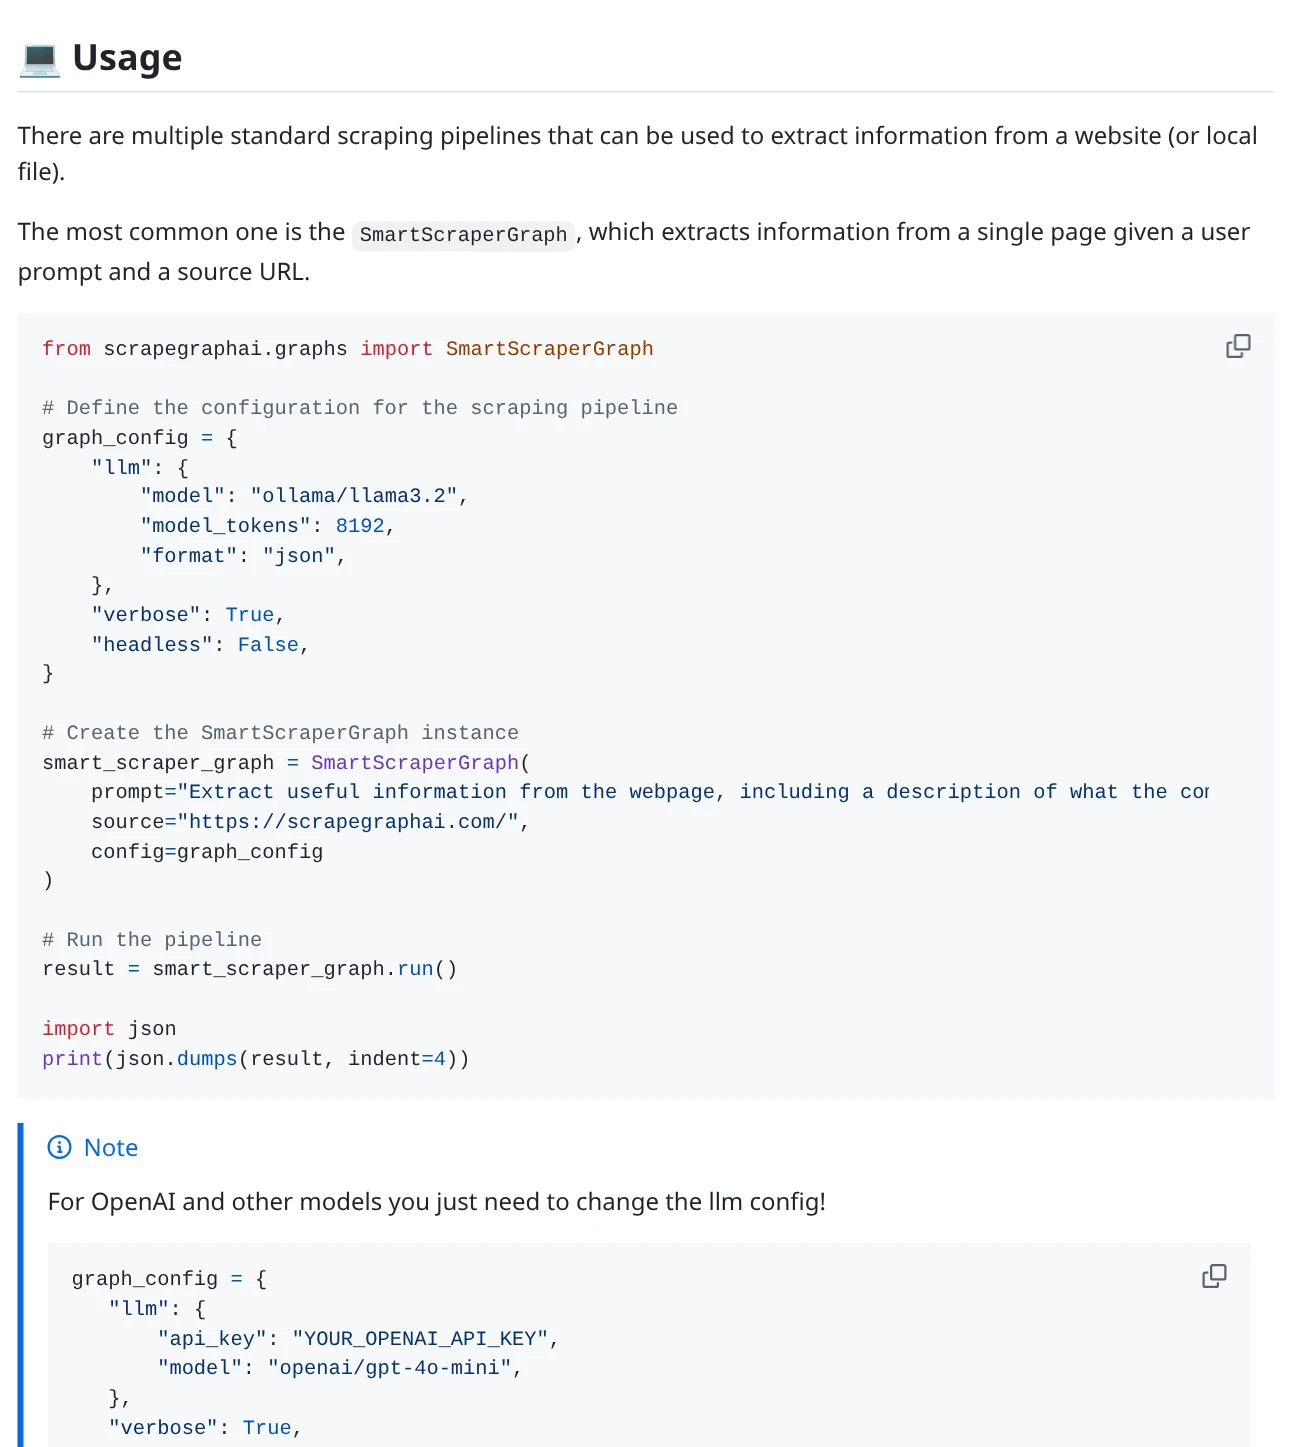
ScrapeGraphAI: Структурированное извлечение на основе LLM
Официальный склад:https://github.com/ScrapeGraphAI/Scrapegraph-ai
ScrapeGraphAI использует модели больших языков и графические процессы для создания каналов сбора веб - страниц и локальных документов. В официальном README говорится, что он может обрабатывать веб - сайты, а также локальные документы, такие как XML, HTML, JSON и Markdown; Библиотека с открытым исходным кодом и управляемый API в рабочем месте, LLM、 Существуют различия в моделях рендеринга браузера, прокси и стоимости.
Технический стек:Python Лицензия:MIT (библиотека Python с открытым исходным кодом; Хостинг API для независимого обслуживания)
- Задачи извлечения могут быть описаны вокруг целевого поля, что уменьшает работу по ручному обслуживанию некоторых селекторов.
- Подходит для интеграции веб - страниц с локальными документами в процесс извлечения информации.
- Библиотека с открытым исходным кодом является лицензией MIT и может работать в собственной инфраструктуре.
- Для автономных версий с открытым исходным кодом требуется собственная настройка инфраструктуры LLM, браузера / Playwright, прокси - сервера и расширения.
- Выход LLM по - прежнему должен быть проверен и не может рассматриваться по умолчанию как полностью точные фактические данные.
Подходит для сцены:Подходит для команд Python, которым необходимо преобразовать веб - страницы или документы в определенные поля JSON и которые готовы настроить свои собственные модели и среды запуска.
Scrapy: зрелый фреймворк рептилий Python
Официальный склад:https://github.com/scrapy/scrapy
Scrapy - это зрелая высокоуровневая веб - структура для извлечения структурированных данных. Официальный склад позиционирует его как кросс - платформенную веб - scraping framework, подходящую для создания поддерживаемых проектов сбора данных с помощью процессов Spider, планирования запросов и обработки данных.
Технический стек:Python (Официальная ссылка на Python 3.11 +) Лицензия:BSD-3-Clause
- Подходит для проектов сбора данных веб - страниц с четкой структурой, четкими правилами и долгосрочным обслуживанием.
- Экологически зрелые, подходящие для организации процессов Spider, запросов, аналитики и вывода данных.
- Лицензия BSD - 3 - Clause, подходящая для включения в различные типы программных проектов (все еще необходимо сохранить лицензионные требования).
- Требуется определенная основа Python и собственные правила анализа целевых сайтов.
- Для страниц, которые сильно зависят от интерфейса JavaScript, обычно требуется дополнительная схема рендеринга браузера.
Подходит для сцены:Подходит для открытых каталогов электронной коммерции, архивов новостей, каталогов документов и другого структурированного сбора страниц.
Playwright: инфраструктура автоматизации браузеров
Официальный склад:https://github.com/microsoft/playwright
Playwright - это фреймворк для веб - тестирования и автоматизации браузера, который управляет Chromium, Firefox и WebKit с помощью единого API. Он может обрабатывать страницы, взаимодействия форм, ожидания страниц, скриншоты и тесты браузера, которые требуют выполнения JavaScript, но сам по себе он не является полной платформой для планирования рептилий и управления данными.
Технический стек:Официальные привязки JavaScript / TypeScript, Python, Java,.NET Лицензия:Apache-2.0
- Унифицированный интерфейс автоматизации браузера для Chromium, Firefox и WebKit.
- Подходит для обработки фронтального рендеринга, интерактивных процессов и скриншотов страниц.
- Можно использовать в качестве исполнительного уровня браузера для рептилий, таких как Crawlee.
- Очереди URL - адресов, хранение данных, планирование сканирования и анализ содержимого обычно требуют реализации самостоятельно или в сочетании с другими рамками.
- Реальный браузер потребляет больше ресурсов, чем простой HTTP - запрос.
Подходит для сцены:Подходит для отображения страниц JavaScript, интерактивного веб - тестирования и выполнения браузера для других проектов рептилий.
Scrapling: Адаптивный анализ и сканирование
Официальный склад:https://github.com/D4Vinci/Scrapling
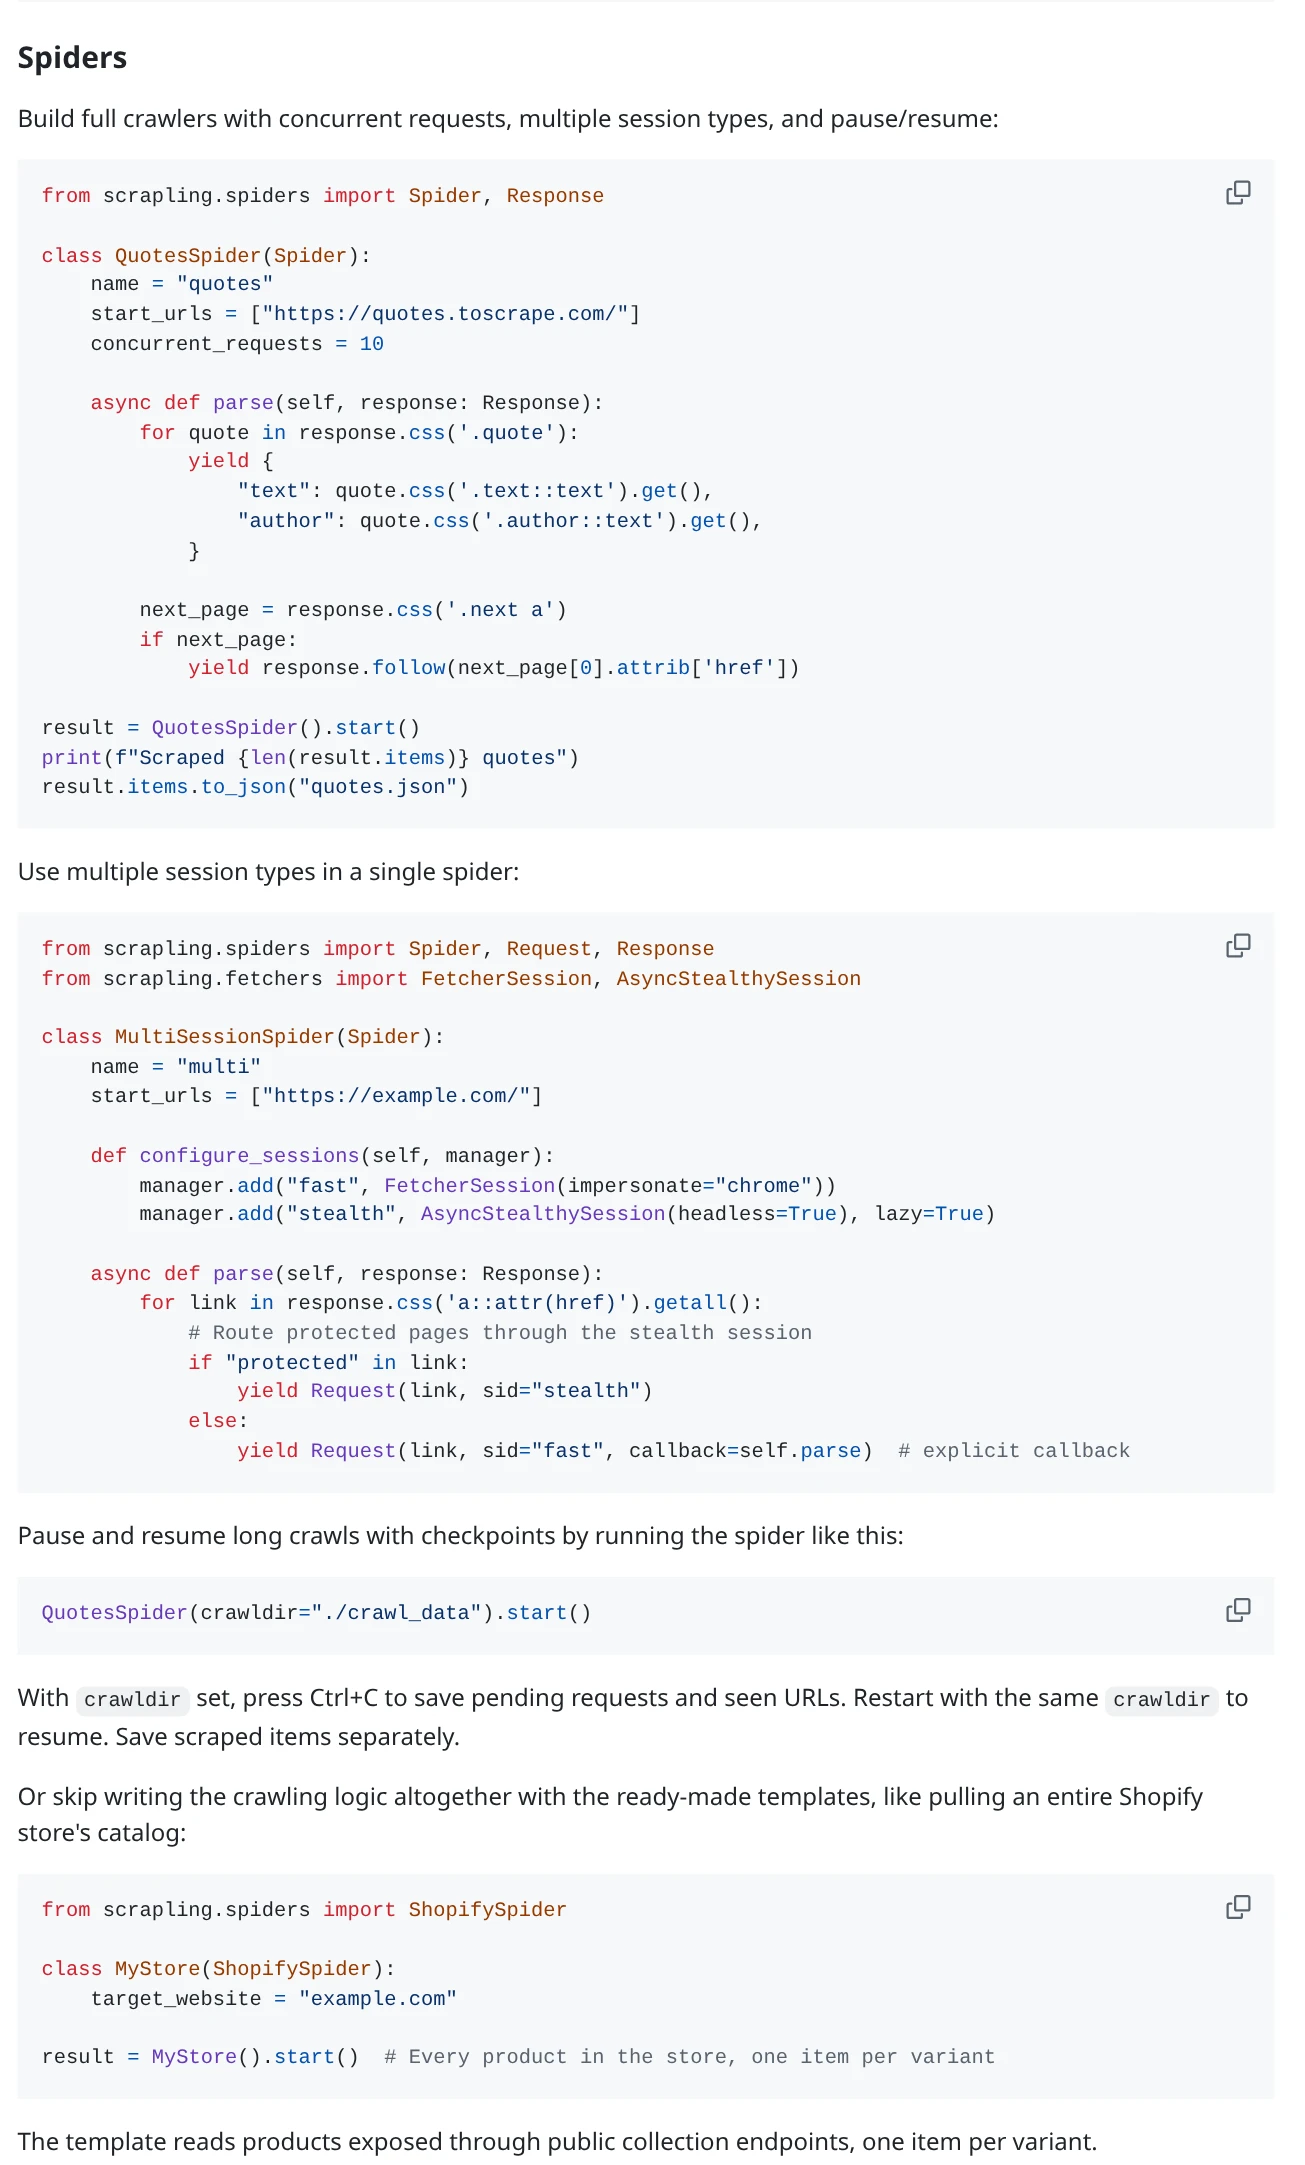
Scrapling объединяет HTTP - сканер, браузер Fetcher, аналитику и параллельный Spider в один и тот же набор инструментов Python. Его адаптивные аналитические возможности используются для переориентации элементов после изменения структуры страницы; В официальном README также перечислены такие функции, как управление сеансами, ротация прокси - серверов, повторное тестирование, приостановление / восстановление и JSON, JSONL, CSV и XML - экспорт.
Технический стек:Python (официальное обозначение README Python 3.10 +) Лицензия:BSD-3-Clause
- Адаптивный анализ может снизить затраты на обслуживание селектора, вызванные изменениями DOM на некоторых страницах.
- Он может быть расширен от одностраничных запросов до параллельных Spider.
- Предоставляет возможности для сеансов, ротации прокси - серверов, повторного тестирования и множественного экспорта данных.
- Базовая установка не идентична необязательным зависимостям, таким как браузер Fetcher / Spider, и extras должен быть установлен в официальном документе, прежде чем включить функции браузера.
- Адаптивный анализ не гарантирует, что все веб - сайты не нуждаются в ручном обслуживании после их обновления.
Подходит для сцены:Подходит для разработчиков Python для работы с проектами с более частыми изменениями структуры DOM, требующими множества методов сканирования.
Puppeteer: Управление браузером Node.js
Официальный склад:https://github.com/puppeteer/puppeteer
Puppeteer управляет библиотекой JavaScript Chrome или Firefox через протокол DevTools или WebDriver BiDi и работает в безголовом режиме по умолчанию. Общие виды использования, перечисленные в официальных документах, включают автоматизацию форм, тестирование UI, скриншоты страниц, генерацию PDF, а также сканирование одностраничных приложений и создание предварительного рендеринга контента.
Технический стек:JavaScript / Node.js Лицензия:Apache-2.0
- Возможности управления браузером для Chrome / Firefox достаточно детальны.
- Подходит для скриншотов, PDF、 Операции формы и страницы, требующие выполнения браузера.
- Он может быть объединен с такими рамками, как Crawlee, чтобы дополнить возможности планирования задач и управления данными.
- Он в основном отвечает за управление браузером и не обеспечивает полного управления проектами рептилий с каналами передачи данных.
- Примеры браузера требуют дополнительного CPU, памяти и поддержки запуска.
Подходит для сцены:Подходит для команды Node.js для управления браузером, скриншотов страниц, генерации PDF и сбора контента SPA.
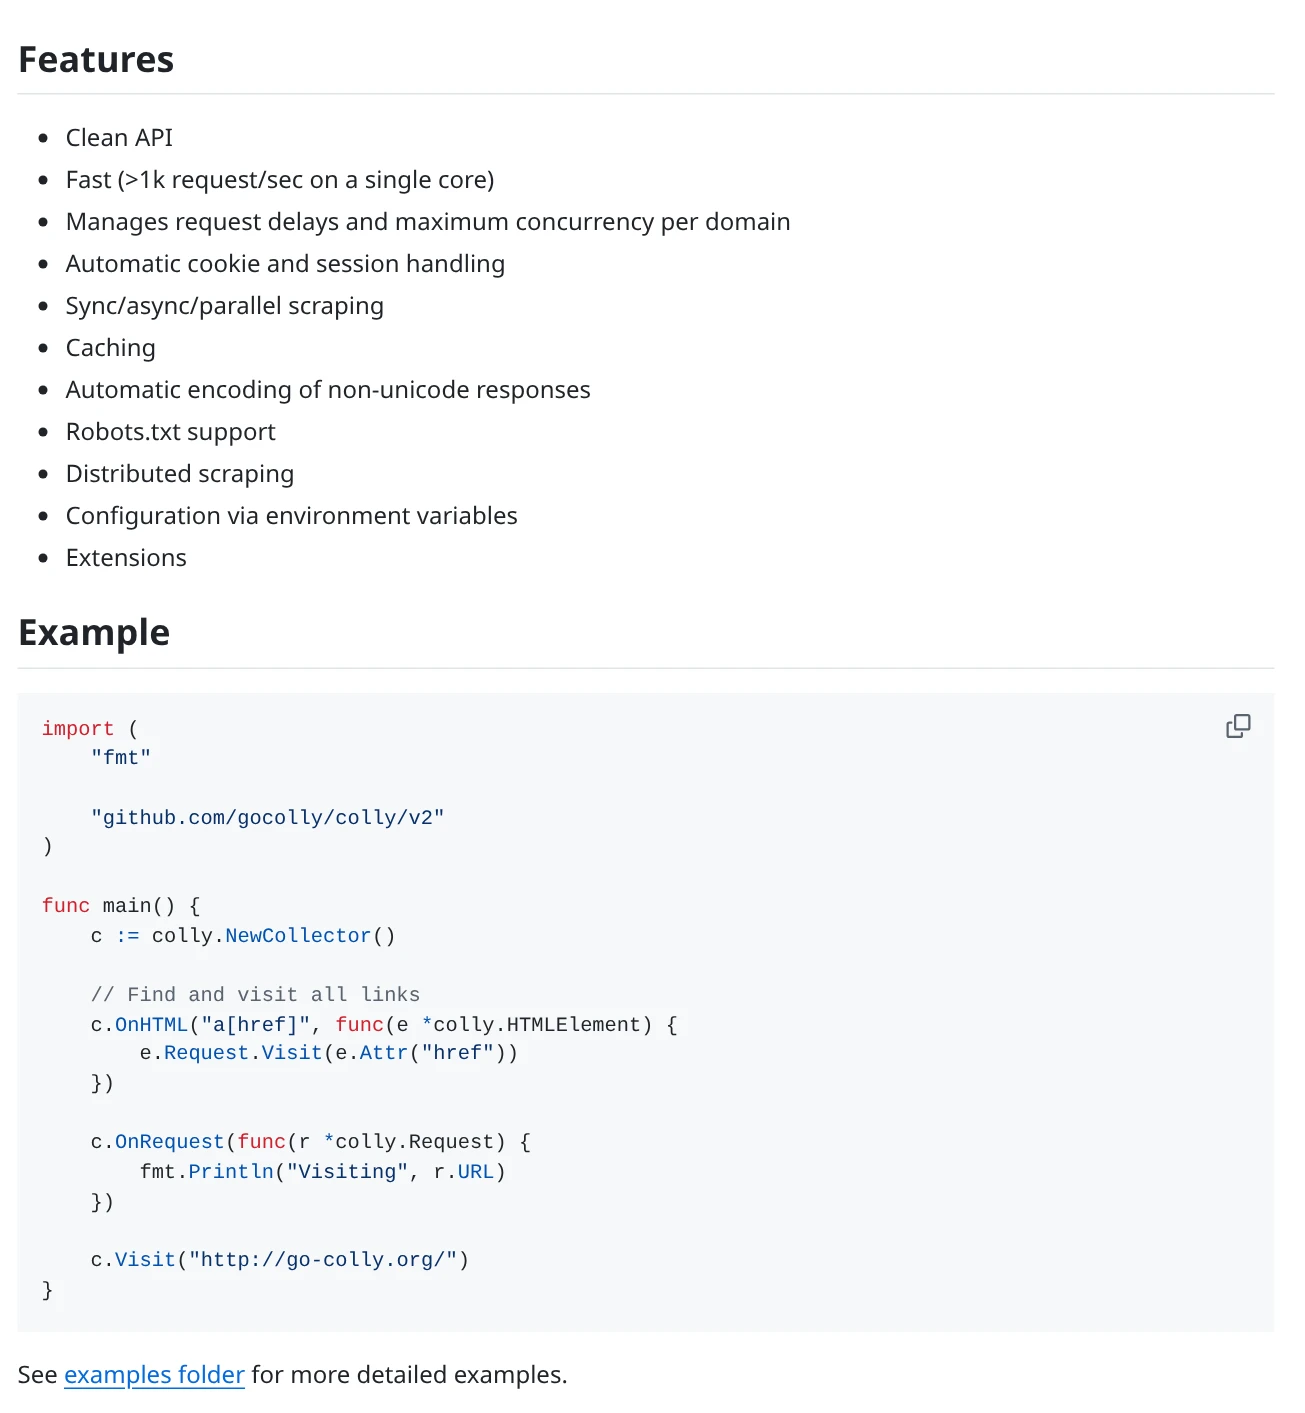
Colly: Go Языковые рептилии Framework
Официальный склад:https://github.com/gocolly/colly
Colly - это фреймворк для сканирования веб - страниц и данных на языке Go. Функции, перечисленные в официальном хранилище, включают управление задержкой и максимальным одновременным выполнением запросов по доменному имени, обработку файлов cookie и сеансов, синхронный / асинхронный / параллельный захват, кэширование, поддержку robots.txt и распределенный захват.
Технический стек:Go Лицензия:Apache-2.0
- Подходит для стека технологий Go и задач сбора запросов HTTP.
- Можно установить верхний предел задержки и параллельности по доменному имени, чтобы легко контролировать ритм доступа.
- Поддерживаются файлы cookie, кэш, robots.txt и распределенный захват.
- В основном для HTTP - сканирования; Страницы, требующие реального браузера для выполнения JavaScript, должны учитывать средства автоматизации браузера.
- Необходимо, чтобы Go развивал возможности и самостоятельно проектировал выход данных, мониторинг и развертывание задач.
Подходит для сцены:Подходит для команды Go для сбора относительно стабильной структуры открытых веб - страниц, каталогов и контента сайта.
Как выбрать три или десять проектов? Быстрое сравнение таблиц.
| проект | Основная ориентация | Язык / Технология | Лицензия | Приоритетные сценарии |
|---|---|---|---|---|
| Firecrawl | Поиск, сканирование и структурирование контента | TypeScript / Node.js Экология | AGPL - 3.0 (ядро) | Сбор материалов AI / RAG |
| Crawl4AI | LLM Дружелюбные асинхронные рептилии | Python | Apache-2.0 | Скачать Markdown / JSON |
| Browser Use | Браузер Agent | Python | MIT (библиотека с открытым исходным кодом) | Многоэтапные интерактивные задачи |
| Crawlee | Производственный каркас рептилий | TypeScript / JavaScript | Apache-2.0 | Поиск очередей, сеансов и браузеров |
| ScrapeGraphAI | Извлечение диаграмм LLM | Python | MIT (библиотека с открытым исходным кодом) | Нажмите поле для извлечения страниц и документов |
| Scrapy | Структурированное сканирование веб - страниц | Python | BSD-3-Clause | Проекты долгосрочного технического обслуживания |
| Playwright | Автоматизация браузера / тестирование | Многоязычная привязка | Apache-2.0 | Динамические страницы и взаимодействия |
| Scrapling | Адаптивный анализ и параллельный захват | Python | BSD-3-Clause | Структура страницы меняется больше. |
| Puppeteer | Управление Chrome / Firefox | JavaScript / Node.js | Apache-2.0 | Снимок экрана, страница PDF, SPA |
| Colly | Скачать HTTP Framework | Go | Apache-2.0 | Технический стек Go и параллельные запросы |
Простые предложения по выбору:Если вы в основном сканируете структурированные страницы, начните с Scrapy или Colly; Если страница требует от браузера выполнения JavaScript, приоритет отдается Playwright или Puppeteer; Если вы хотите преобразовать веб - страницу в AI, сравните Firecrawl, Crawl4AI и ScrapeGraphAI. Если необходимо, чтобы агент выполнял многоступенчатые действия, обратитесь к Browser Use.
Расширенные рекомендации: ovo Browser Официальный проект GitHub и возможности автоматизации
Десять проектов выше в основном отвечают за « как найти страницу, прочитать контент, проанализировать поле или выполнить веб - взаимодействие». Когда команде также необходимо управлять различными рабочими средами браузера, конфигурацией прокси - сервера и автоматизированными процессами браузера, необходимо учитывать уровень среды работы браузера.
Позиция ovo Browser - это связь между управлением средой браузера и автоматизацией, а не рептилиями. Он не заменяет функции сканирования, анализа контента и хранения данных в Scrapy, Crawlee или Firecrawl; Он может служить связующим звеном между средой браузера и средствами автоматизации.
Хранилище ядра ovo Browser Chromium
Официальный открытый склад:ovobrowsersupport/ovobrowserА.
Хранилище README позиционирует его как модифицированное ядро отпечатков пальцев Chromium с исходным кодом и предоставляет портативные пакеты Windows x64 с примерами разработчиков. В описании хранилища перечислены соответствующие элементы конфигурации, такие как Canvas, WebGL, Audio, ClientRects, Font, а также примеры запуска для таких языков, как Python, Node.js, Go, C #, PowerShell, Java и Rust. На странице склада указана лицензия MIT.
Необходимо различать:Этот склад предназначен для разработчиков и содержит описание переносного пакета ядра и примеры запуска; Это не веб - рептилия фреймворка и не полный исходный код графического клиента ovo Browser.
Графический клиент ovo Browser представляет склад
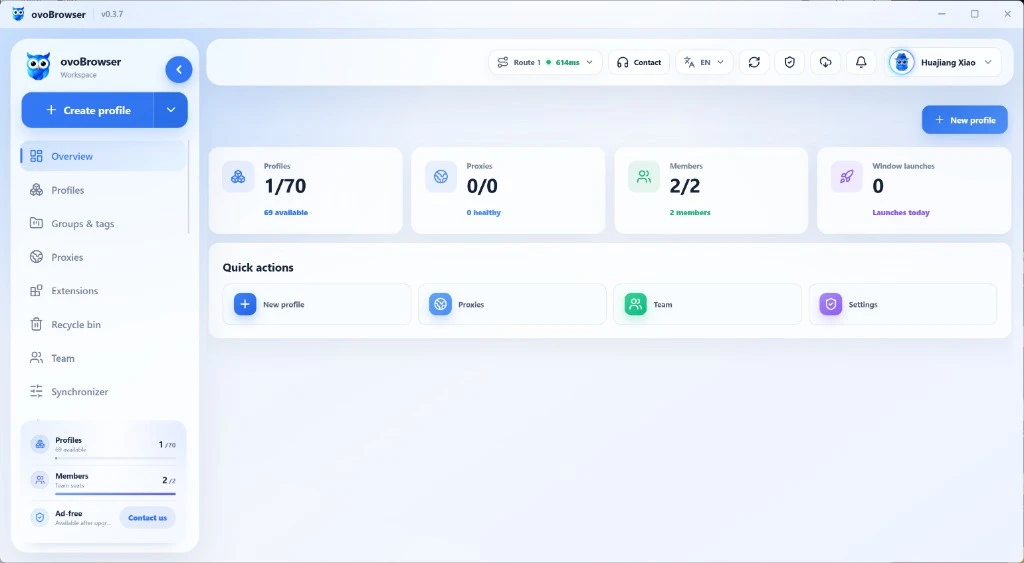
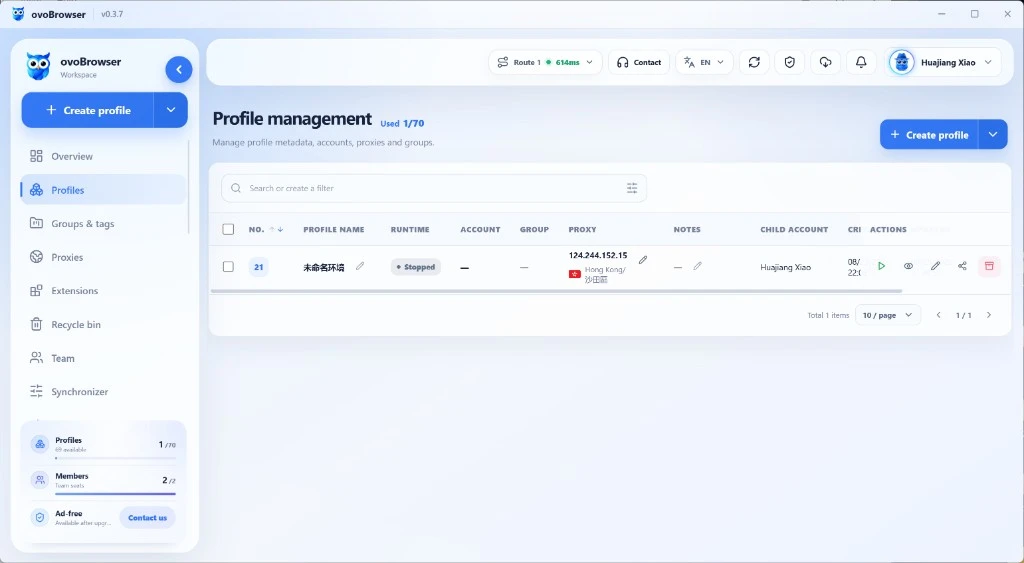
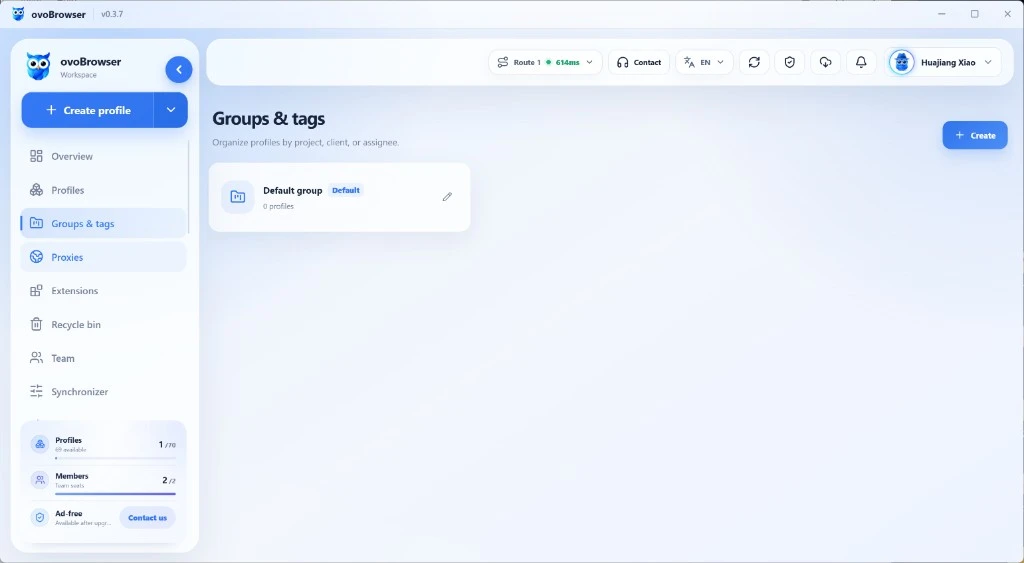
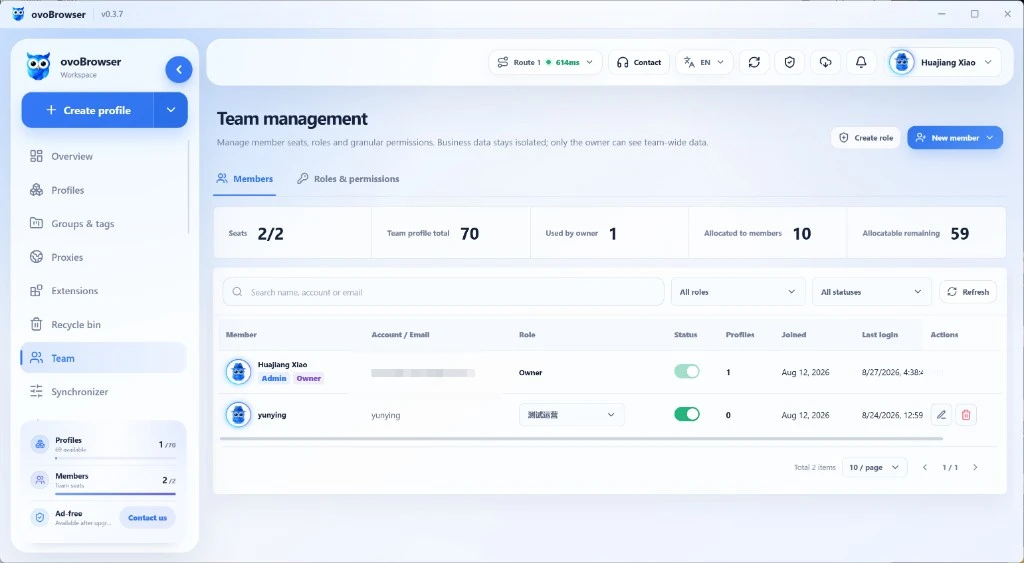
Официальный открытый склад:ovobrowsersupport/ovobrowser-mangerХранилище README описывает его как введение и скриншоты для клиентов рабочего стола для обычных пользователей, показывая, что среда браузера, прокси, команда и синхронизация окон могут управляться в графическом интерфейсе.
Версия скриншота клиента, отмеченная в README, является v0.3.7. Изображение ниже взято из каталога docs / assets на официальном складе и относится к скриншоту реального продукта; Если на момент публикации клиентский интерфейс был обновлен, он должен быть заменен скриншотом текущей версии и указан в примечании к рисунку.
Локальный API ovo Browser: подключение инструментов автоматизации к среде браузера
Официальная локальная документация API ovo Browser показывает, что локальный HTTP API может управлять средой браузера, группировкой, метками, прокси - серверами, станциями переработки и процессами браузера. Интерфейс POST + JSON Body; Интерфейсы, перечисленные в документе, включают в себя список среды, среду создания / обновления, администрирование прокси - серверов, а также открытие, запрос и закрытие среды браузера.
После открытия среды ответ API возвращается pid、ws、http Ожидание информации; Официальная документация уточняет, что возврат ws Его можно использовать в Playwright или Puppeteer. Это дает возможность связать управление окружающей средой ovo Browser с существующим кодом автоматизации браузера.
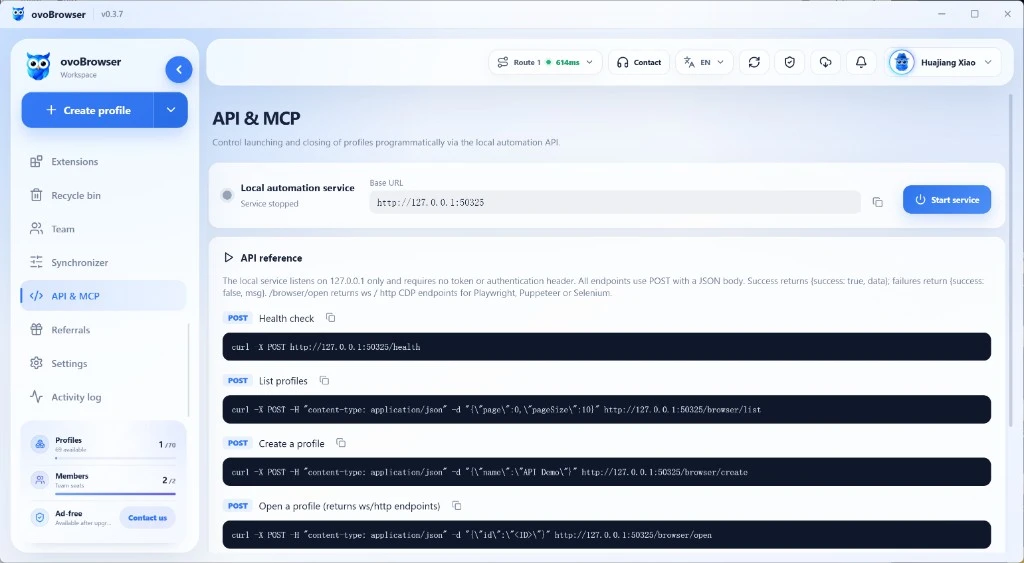
Примеры открытых экологических запросов в официальных документах:
curl --location 'http://127.0.0.1:50325/browser/open' \
  --header 'Content-Type: application/json' \
  --data '{"id":"YOUR_PROFILE_ID","headless":false}'
После успешного запроса ответ содержит информацию о соединении процесса с браузером. Разработчики смогут вернуться по официальной документации ws Для Playwright или Puppeteer; Код подключения должен соответствовать текущей версии клиента и официальному документу API.
Более четкий рабочий процесс ovo Browser + Open Source для рептилий
- Выберите рамки сбора:Выберите Scrapy, Crawlee, Crawlee, Crawl4AI или используйте Playwright / Puppeteer для обработки страниц, которые должен выполнять браузер.
- Создание среды браузера:В ovo Browser среды создаются и называются по проектам, а агенты настраиваются по фактическим потребностям сети.
- Открыть окружение с помощью локального API:Используйте локальный API, чтобы открыть указанную среду и прочитать информацию о соединении браузера в ответе.
- Инструменты автоматизации подключения:Информация о подключении передается в Playwright или Puppeteer в соответствии с официальным документом, где разработчики пишут логику доступа к странице, ожидания, извлечения и сохранения.
- Управление данными и ритмом доступа:Сохраните результаты сбора в своей базе данных или файле и установите разумные параллельные, отложенные и неудачные повторные попытки.
Безопасность при использовании локальных API ovo Browser
ovo Browser Официальная документация API показывает, что локальный API прослушивается только 127.0.0.1Не требуется Token, Bearer Token или x-api-keyПоэтому услуги следует использовать только на собственных компьютерах и не подвергать локальные порты API публичной сети или ненадежной локальной сети. Официальные документы также напоминают, что учетные записи, файлы cookie, ключи 2FA и прокси - пароли являются конфиденциальной информацией и не записываются в публичный журнал.
Кроме того, изоляция среды браузера и конфигурация прокси - сервера не означают, что можно обойти контроль доступа к целевому сайту. Разработчики должны соблюдать условия обслуживания целевого сайта, robots.txt、 Требования к конфиденциальности, правила авторского права и применимое законодательство; Для контента, требующего входа в систему, оплаты, персональных данных или прямого запрета на автоматический доступ, необходимо сначала получить соответствующее разрешение.
V. Часто задаваемые вопросы
Проект GitHub с открытым исходным кодом полностью бесплатный?
Лицензия с открытым исходным кодом позволяет пользователям использовать, изменять или распространять код при соответствующих условиях, но не означает, что эксплуатационные расходы равны нулю. Сервер, прокси - сервер, ресурсы запуска браузера, LLM API и управляемые облачные сервисы могут нести расходы; Обязательства по лицензиям AGPL, Apache, MIT, BSD также различны, и файлы LICENSE в корневом каталоге проекта должны быть доступны для бизнеса.
Как выбрать Scrapy, Playwright и Firecrawl?
Scrapy лучше подходит для традиционного структурированного сбора веб - страниц; Playwright - это система автоматизации браузера и тестирования, подходящая для обработки рендеринга JavaScript и взаимодействия страниц; Firecrawl предназначен для сканирования, поиска и структурированного вывода веб - контента, особенно для рабочих процессов AI / RAG. Они решают разные проблемы и могут быть объединены в одну и ту же систему.
Является ли ovo Browser программным обеспечением для рептилий?
Не совсем. ovo Browser в основном используется для управления средой браузера, прокси - серверами и автоматизированными соединениями. Реальное планирование URL - адресов, анализ веб - страниц, очистка данных, запись в базу данных и другие задачи по - прежнему должны выполняться Scrapy, Crawlee, Firecrawl или собственным кодом разработчика.
Можно ли подключить ovo Browser к Playwright или Puppeteer?
Официальная клиентская инструкция ovo Browser и локальная документация API описывают способы подключения к Playwright и Puppeteer. Официальный API возвращает информацию о соединении браузера после открытия среды, в которой ws Можно использовать Playwright или Puppeteer. Для реализации используйте текущую версию документа.
Может ли использование рептилий гарантировать, что сайт не будет ограничен?
Не могу. Ни одна конфигурация фреймворка или браузера не гарантирует, что целевой сайт всегда будет иметь автоматический доступ. Следует соблюдать правила целевого сайта и устанавливать разумную частоту доступа; Не пытайтесь обойти несанкционированный контроль доступа при отказе в доступе, коде проверки, стене входа или ограничении доступа.
Заключение: сначала выберите пару инструментов, а затем создайте стабильный, соответствующий рабочий процесс
Экология рептилий с открытым исходным кодом на GitHub охватывает несколько уровней от простого HTTP - сканирования до автоматизации браузера и структурированного извлечения ИИ. Scrapy и Colly подходят для традиционного сбора, Crawlee - для создания проектов с управлением очередями и сеансами, Playwright и Puppeteer - для управления браузером, а Firecrawl, Crawl4AI и ScrapeGraphAI - для веб - контента, входящего в рабочий процесс ИИ.
Если проект также требует независимого управления средой браузера и подключения среды к существующим автоматизированным программам, вы можете узнать больше об официальном хранилище ядра GitHub ovo Browser с локальным API. Пусть каждый инструмент отвечает за то, в чем он хорош, часто надежнее, чем ожидать, что одно программное обеспечение сделает всю работу.
Справочные материалы и официальные источники
- Оригинал: AdsPower: GitHub Recommendations Project 2026 (только по теме и структуре)
- Firecrawl Официальный GitHub
- Официальный сайт Crawl4AI GitHub
- Browser Use Официальный GitHub
- Официальный сайт Crawlee GitHub
- Скачать ScrapeGraphAI на GitHub
- Официальный сайт Scrapy GitHub
- Официальный сайт Playwright GitHub
- Официальный GitHub
- Официальный GitHub
- Официальный GitHub
- Хранилище ядра ovo Browser Chromium
- Презентация клиента ovo Browser и Хранилище скриншотов
- ovo Browser Локальный API Официальный документ
Похожие статьи
2026 Руководство по росту страницы Facebook
Для трансграничной электронной коммерции, зарубежных брендов и операторов социальных сетей рост домашней страницы Facebook - это не просто увеличение количества публикаций, а постоянное предоставление ценного оригинального контента, четкое позиционирование бренда, своевременное реагирование на аудиторию и корректировка контента в соответствии с данными. Эта статья начинается с подготовки домашней страницы, планирования контента, 30 - дневного темпа работы, совместной работы и репликации данных, а также описывает, как ovo Browser помогает командам более четко управлять несколькими утвержденными бизнес - средами.
Читать статью
Как выбрать ovo Browser, GoLogin и AdsPower?
Бесплатная версия, автоматизация, полный контраст цен
Читать статью
Почему учетная запись Claude вызывает проверку, предупреждение или ограничение?
В этой статье, следуя порядку « Статус учетной записи - область и сеть - проверка платежей - поведение использования - устройства и сеансы - управление средой», рассматриваются аспекты, которые стоит проверить, и описывается, как ovo Browser помогает пользователям упорядочить рабочую среду браузера.
Читать статью