 ovobrowser
Chuyển nhanh đến nội dung bài viết
2026 GitHub Open Source Crawler Project Đề xuất: 10 công cụ để thu thập với Hướng dẫn tích hợp tự động ovo Browser
Từ việc thu thập trang web AI, framework thu thập thông tin truyền thống, tự động hóa trình duyệt đến thu thập dữ liệu đồng thời Go, kiểm tra 10 dự án nguồn mở GitHub thực sự, kiểm tra mục đích dự án, ngăn xếp kỹ thuật và giao thức nguồn mở và giới thiệu cách kho GitHub chính thức của ovo Browser và API cục bộ kết nối với các công cụ như Playwright và Puppeteer để giúp các nhà phát triển xây dựng quy trình làm việc dữ liệu web rõ ràng và có thể duy trì hơn.
Muốn xây dựng hệ thống thu thập dữ liệu trang web, không nhất thiết phải thu thập từ số 0. Đã có rất nhiều dự án mã nguồn mở được thành lập trên GitHub, bao gồm các phần khác nhau như thu thập dữ liệu HTTP truyền thống, dựng trang JavaScript, tự động hóa trình duyệt, trích xuất nội dung AI và lập lịch tác vụ đồng thời.
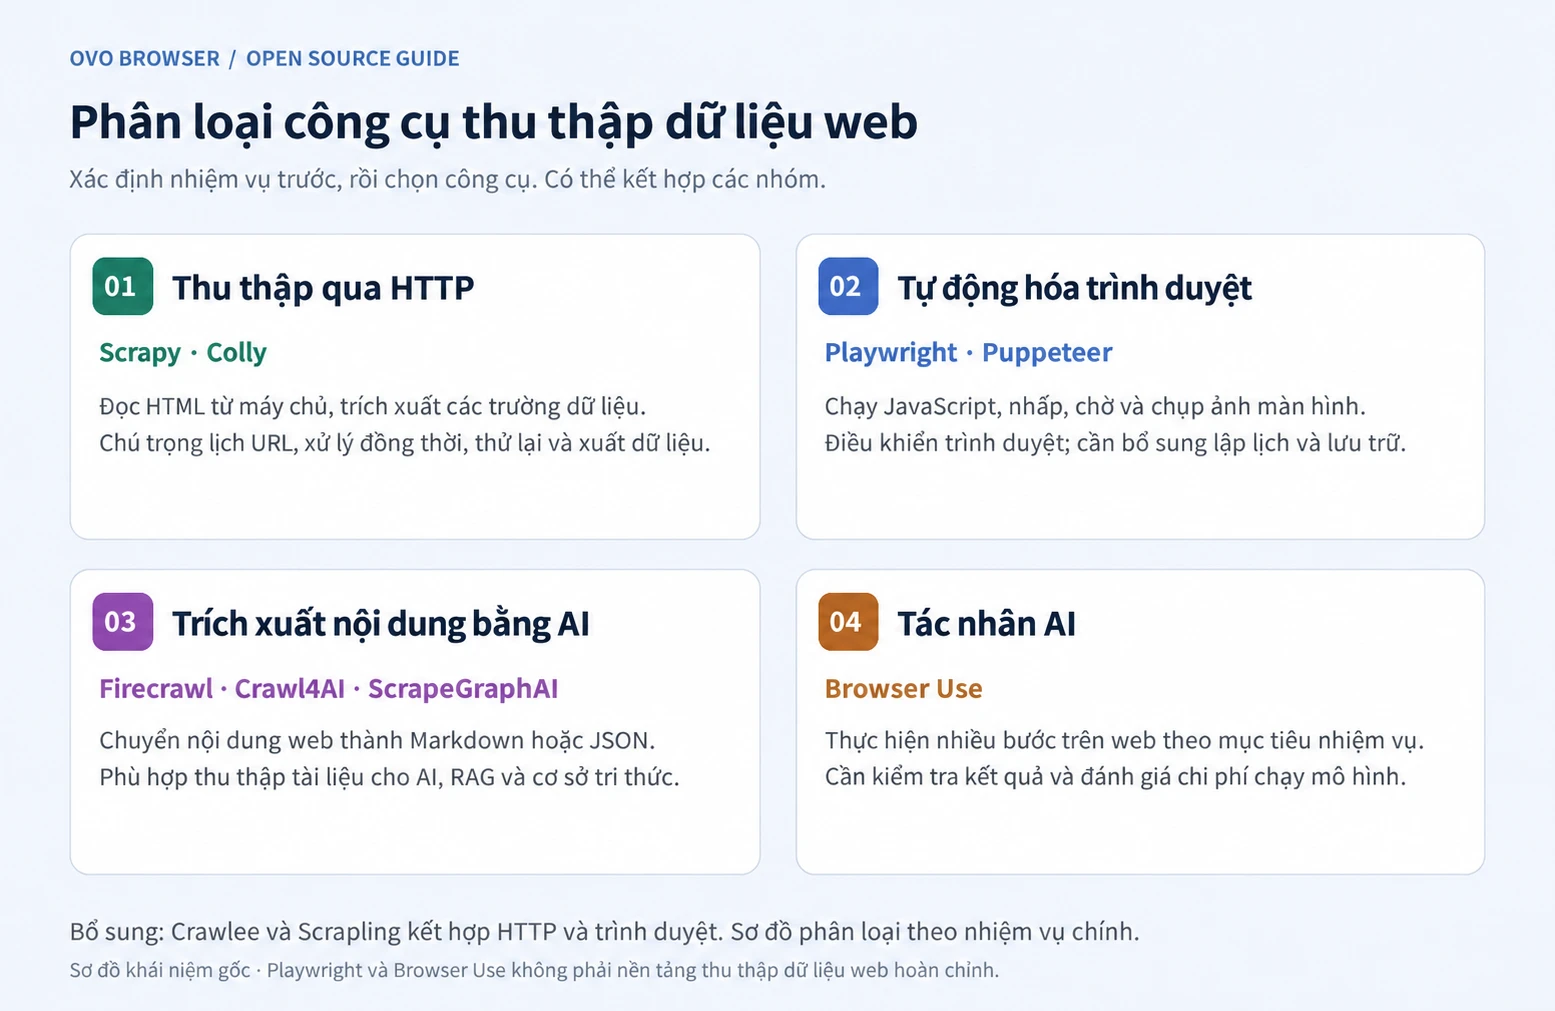
Nhưng "dự án thu thập dữ liệu" không phải là một loại duy nhất: Scrapy, Colly thiên về khung thu thập; Playwright, Puppeteer chịu trách nhiệm kiểm soát trình duyệt; Browser Use hoạt động web nhiều bước cho tác nhân AI; Firecrawl, Crawl4AI và ScrapeGraphAI tập trung nhiều hơn vào cấu trúc nội dung web và quy trình làm việc AI. Việc xác nhận các tác vụ trước khi so sánh các công cụ thường hiệu quả hơn so với việc chỉ nhìn vào số lượng sao trên GitHub.
Bài viết này đề cập đến các lựa chọn và cách tổ chức của AdsPower, kiểm tra độc lập kho GitHub chính thức, README và thông tin giấy phép cho từng dự án và bổ sung cho hướng dẫn tích hợp kho GitHub công khai và API cục bộ của ovo Browser. Định vị dự án, nhà trọ kỹ thuật và giấy phép lấy tài liệu chính thức được kiểm tra lần này làm chuẩn; Số lượng sao không được sử dụng làm cơ sở để xếp hạng vì nó thay đổi liên tục.
Đầu tiên, hãy tìm hiểu xem: bạn cần một trình thu thập thông tin, tự động hóa trình duyệt hay AI Agent?
- Thu thập dữ liệu trang web truyền thống:Nội dung trang chủ yếu được trả về bởi máy chủ, tập trung vào lập kế hoạch URL, quy tắc phân tích cú pháp, đồng thời, thử lại và lưu trữ dữ liệu. Có thể ưu tiên Scrapy, Colly.
- Trang động JavaScript:Playwright, Puppeteer hoặc Crawlee, Crawl4AI, Scrapling sử dụng khả năng thực thi trình duyệt tích hợp khi bạn cần trình duyệt để thực hiện kịch bản, chờ đợi các yếu tố hoặc tương tác mô phỏng.
- Thu thập nội dung AI/RAG:Để chuyển đổi trang web của bạn thành Markdown, JSON hoặc Knowledge Base, hãy xem Firecrawl, Crawl4AI và ScrapeGraphAI.
- Tương tác trang web phức tạp:Yêu cầu Agent tự nhấp, cuộn và điền vào biểu mẫu dựa trên mục tiêu để tìm hiểu về Browser Use. Nó không phải là sự thay thế trực tiếp cho các trình thu thập thông lượng cao truyền thống.
Giới thiệu về GitHub Open Source Crawler&Browser Automation Project
Sau đây xin giới thiệu 10 kho mã nguồn mở thực sự tồn tại theo định vị dự án. Thứ tự các mục được sử dụng cho các tổ chức đọc và không đại diện cho bảng xếp hạng tổng hợp.
Firecrawl: AI thu thập trang web/cấu trúc nội dung
Kho chính thức:https://github.com/firecrawl/firecrawl
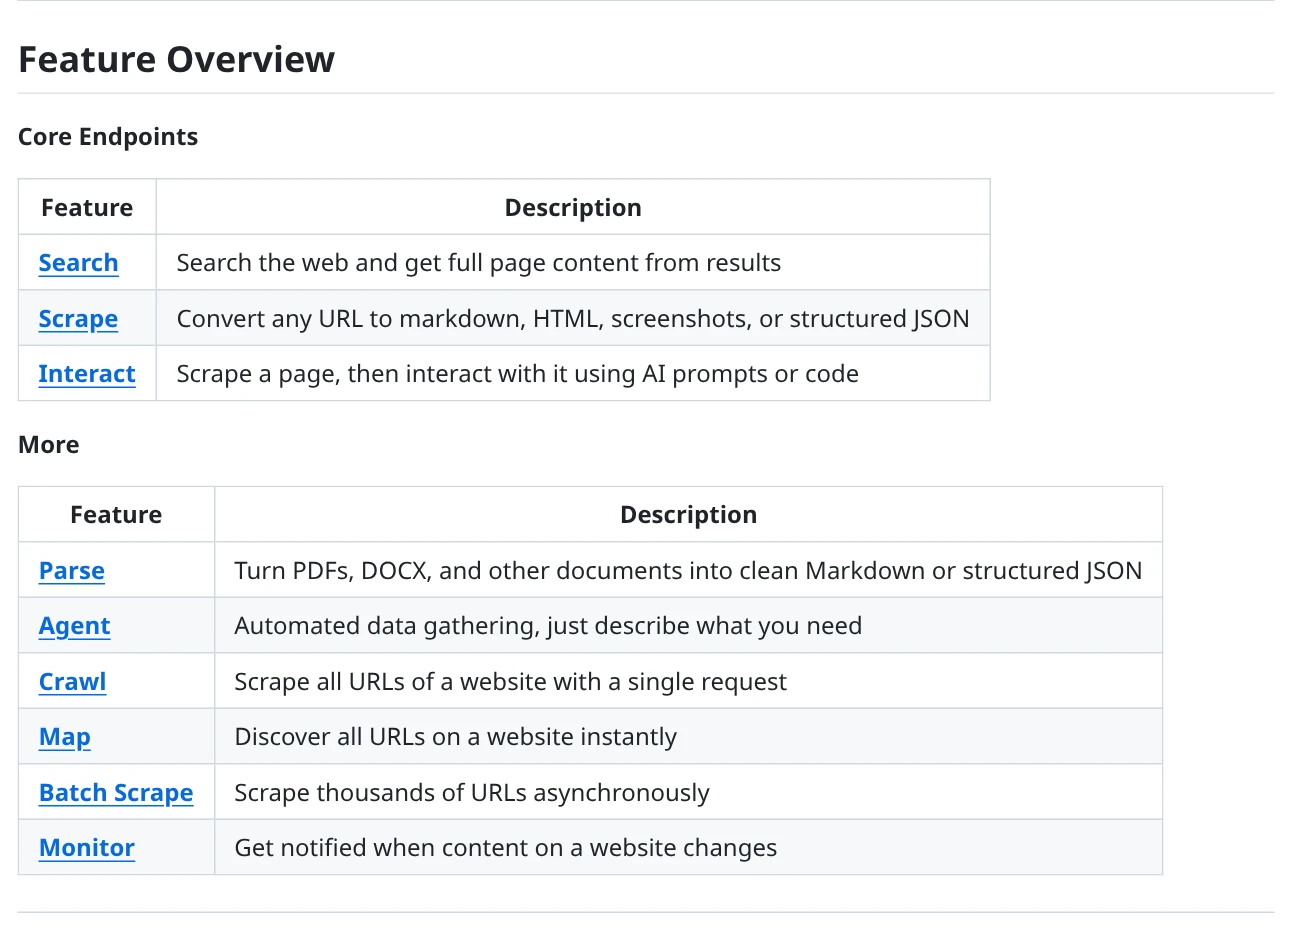
Firecrawl cung cấp các khả năng như Search, Scrape, Crawl, Map và Interact để sắp xếp nội dung trang web thành Markdown, HTML, ảnh chụp màn hình hoặc JSON có cấu trúc, cũng như thực hiện các tương tác như nhấp, cuộn, nhập và chờ trên trang trước khi trích xuất nội dung.
Nhà trọ kỹ thuật:TypeScript/Node.js Sinh thái Giấy phép:AGPL-3.0 (Dự án cốt lõi) Một số thành phần SDK và UI là MIT)
- Thích hợp để chuyển đổi nội dung trang web thành Markdown hoặc JSON có thể đọc LLM.
- Hỗ trợ Single Page Crawl, Whole Site Crawl, Site URL Map và thu thập trang tương tác.
- Kho chính thức cung cấp các đường dẫn tự lưu trữ nguồn mở trong khi cũng cung cấp các dịch vụ đám mây được quản lý.
- AGPL-3.0 được sử dụng cho các dự án cốt lõi và nghĩa vụ cấp phép phải được kiểm tra bởi nhóm pháp lý/kỹ thuật trước khi tích hợp hoặc phân phối thương mại.
- Dịch vụ đám mây quản lý bao gồm các khả năng bổ sung, không thể hiểu mặc định chức năng đám mây là phiên bản nguồn mở của địa phương.
Phù hợp với cảnh:Thích hợp cho cơ sở kiến thức RAG, thu thập thông tin trang AI Agent, sắp xếp nội dung tài liệu và xây dựng cơ sở nội dung trang.
Crawl4AI: Trình thu thập thông tin thân thiện LLM/RAG
Kho chính thức:https://github.com/unclecode/crawl4ai
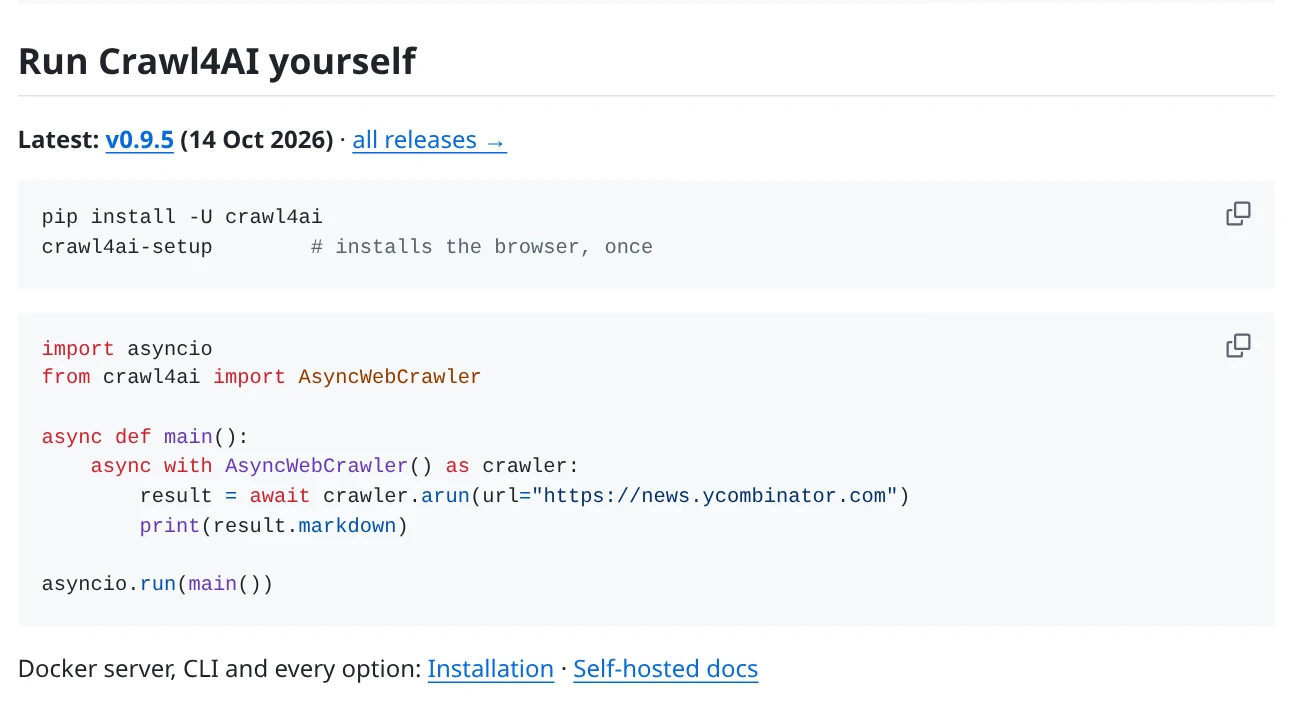
Crawl4AI là trình thu thập dữ liệu web mã nguồn mở cho các ứng dụng AI có khả năng biến các trang thành Markdown có cấu trúc rõ ràng và trích xuất dữ liệu có cấu trúc thông qua các chính sách CSS, XPath hoặc LLM. Tài liệu chính thức cũng giới thiệu về asynchronous crawling, JavaScript page rendering, deep crawling, screenshot, PDF và local/Docker self-hosting.
Nhà trọ kỹ thuật:Python Giấy phép:Apache-2.0 (README chính thức đề nghị thêm chữ ký dự án theo yêu cầu)
- Đầu ra Markdown phù hợp với quy trình làm việc RAG hoặc LLM tiếp theo.
- Kết hợp trích xuất CSS/XPath truyền thống với trích xuất có cấu trúc LLM.
- Hỗ trợ chạy Python cục bộ hoặc tự lưu trữ bằng Docker theo tài liệu chính thức.
- Trình duyệt, proxy, môi trường chạy và tài nguyên đồng thời cần được cấu hình và duy trì bởi chính nó.
- Khai thác LLM liên quan đến chi phí tài nguyên hoặc API của mô hình đã chọn; Đừng nhầm lẫn khả năng của một API đám mây được quản lý với các thư viện nguồn mở địa phương.
- Bạn nên làm theo hướng dẫn đã ký của mục README khi sử dụng.
Phù hợp với cảnh:Thích hợp cho các nhà phát triển cần chuyển dữ liệu trang web sang Markdown, JSON và xây dựng thêm cơ sở kiến thức hoặc hệ thống truy xuất AI.
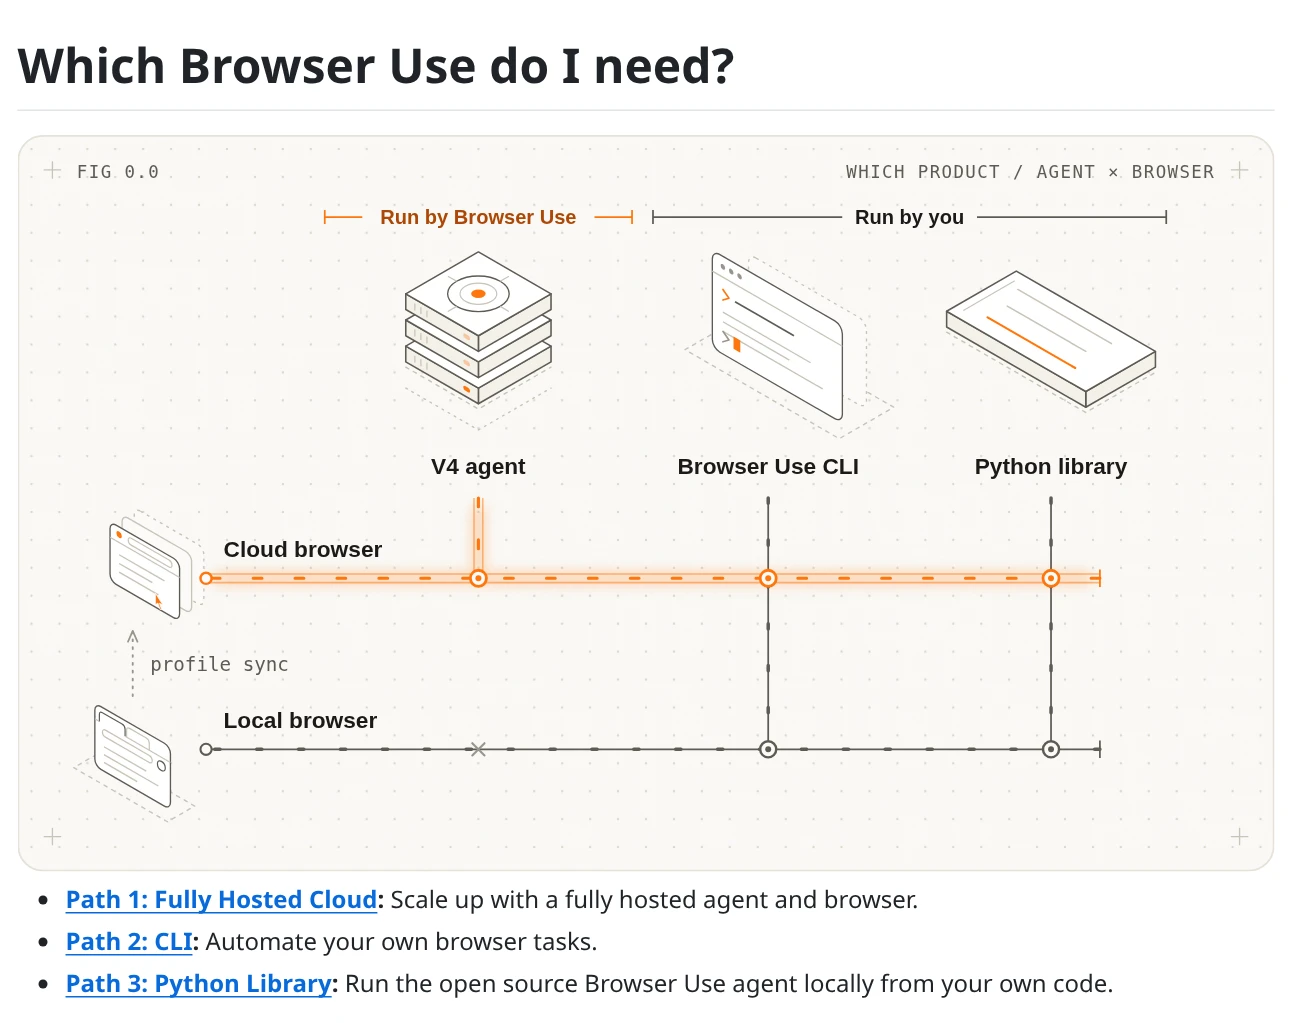
Browser Use: Trình duyệt AI Agent
Kho chính thức:https://github.com/browser-use/browser-use
Trọng tâm của Browser Use không phải là trình thu thập hàng đợi URL truyền thống, mà là cho phép AI Agent hoàn thành các tác vụ trang web nhiều bước thông qua trình duyệt. README chính thức cung cấp các đường dẫn sử dụng như thư viện Python tại chỗ, CLI và đám mây được quản lý; Các thư viện cục bộ hoạt động với các mô hình do nhà phát triển lựa chọn và trình duyệt cục bộ/đám mây.
Nhà trọ kỹ thuật:Python (và có hệ sinh thái công cụ TypeScript liên quan) Giấy phép:MIT (thư viện Python nguồn mở) Thông báo cập nhật phần mềm QLTN Hồ sơ ((((
- Thích hợp cho các tác vụ tương tác phức tạp đòi hỏi nhấp chuột, cuộn, điền vào biểu mẫu và hoạt động trên các trang.
- Thư viện Python mã nguồn mở sử dụng giấy phép MIT.
- Trình duyệt cục bộ có thể được chọn bằng tài liệu chính thức hoặc sử dụng dịch vụ trình duyệt được quản lý.
- Đó là một trình duyệt Agent, không phải là một crawler framework truyền thống thông lượng cao.
- Có thể có thêm chi phí cho lý luận mô hình, API mô hình của bên thứ ba hoặc dịch vụ trình duyệt được quản lý.
- Kết quả thực hiện Agent bị ảnh hưởng bởi mô hình, thay đổi trang web và thiết kế nhiệm vụ và yêu cầu kiểm tra con người.
Phù hợp với cảnh:Thích hợp cho các tác vụ nghiên cứu yêu cầu tương tác trình duyệt, hoạt động web lặp đi lặp lại và quy trình làm việc AI Agent.
4. Crawlee: Khung thu thập dữ liệu cấp sản xuất
Kho chính thức:https://github.com/apify/crawlee
Crawlee cung cấp cho các nhà phát triển Node.js một giao diện thống nhất giữa HTTP và Headless. Các khả năng được liệt kê trong kho chính thức bao gồm hàng đợi URL liên tục, phù hợp lưu trữ dữ liệu, mở rộng theo tài nguyên hệ thống, xoay proxy, quản lý phiên, thử lại lỗi và điều khiển trình duyệt thực thông qua Playwright hoặc Puppeteer.
Nhà trọ kỹ thuật:TypeScript / JavaScript(Node.js) Giấy phép:Apache-2.0
- Giao diện khung thống nhất có thể được sử dụng giữa HTTP Grab và Browser Grab.
- Tích hợp các thành phần quy trình làm việc sản xuất như hàng đợi, lưu trữ, phiên, xoay proxy và thử lại.
- Hỗ trợ các công cụ tự động hóa trình duyệt như Playwright và Puppeteer.
- Thích hợp hơn cho các nhóm có khả năng kỹ thuật Node.js và vẫn phải thiết kế dữ liệu để làm sạch, duy trì và giám sát.
- Việc triển khai sản xuất đòi hỏi phải cấu hình hợp lý tần suất truy cập hàng đợi, đồng thời, đại lý và trang web.
Phù hợp với cảnh:Thích hợp cho các nhóm TypeScript/JavaScript để xây dựng các hệ thống thu thập thông tin yêu cầu hàng đợi nhiệm vụ, quản lý phiên và hiển thị trình duyệt.
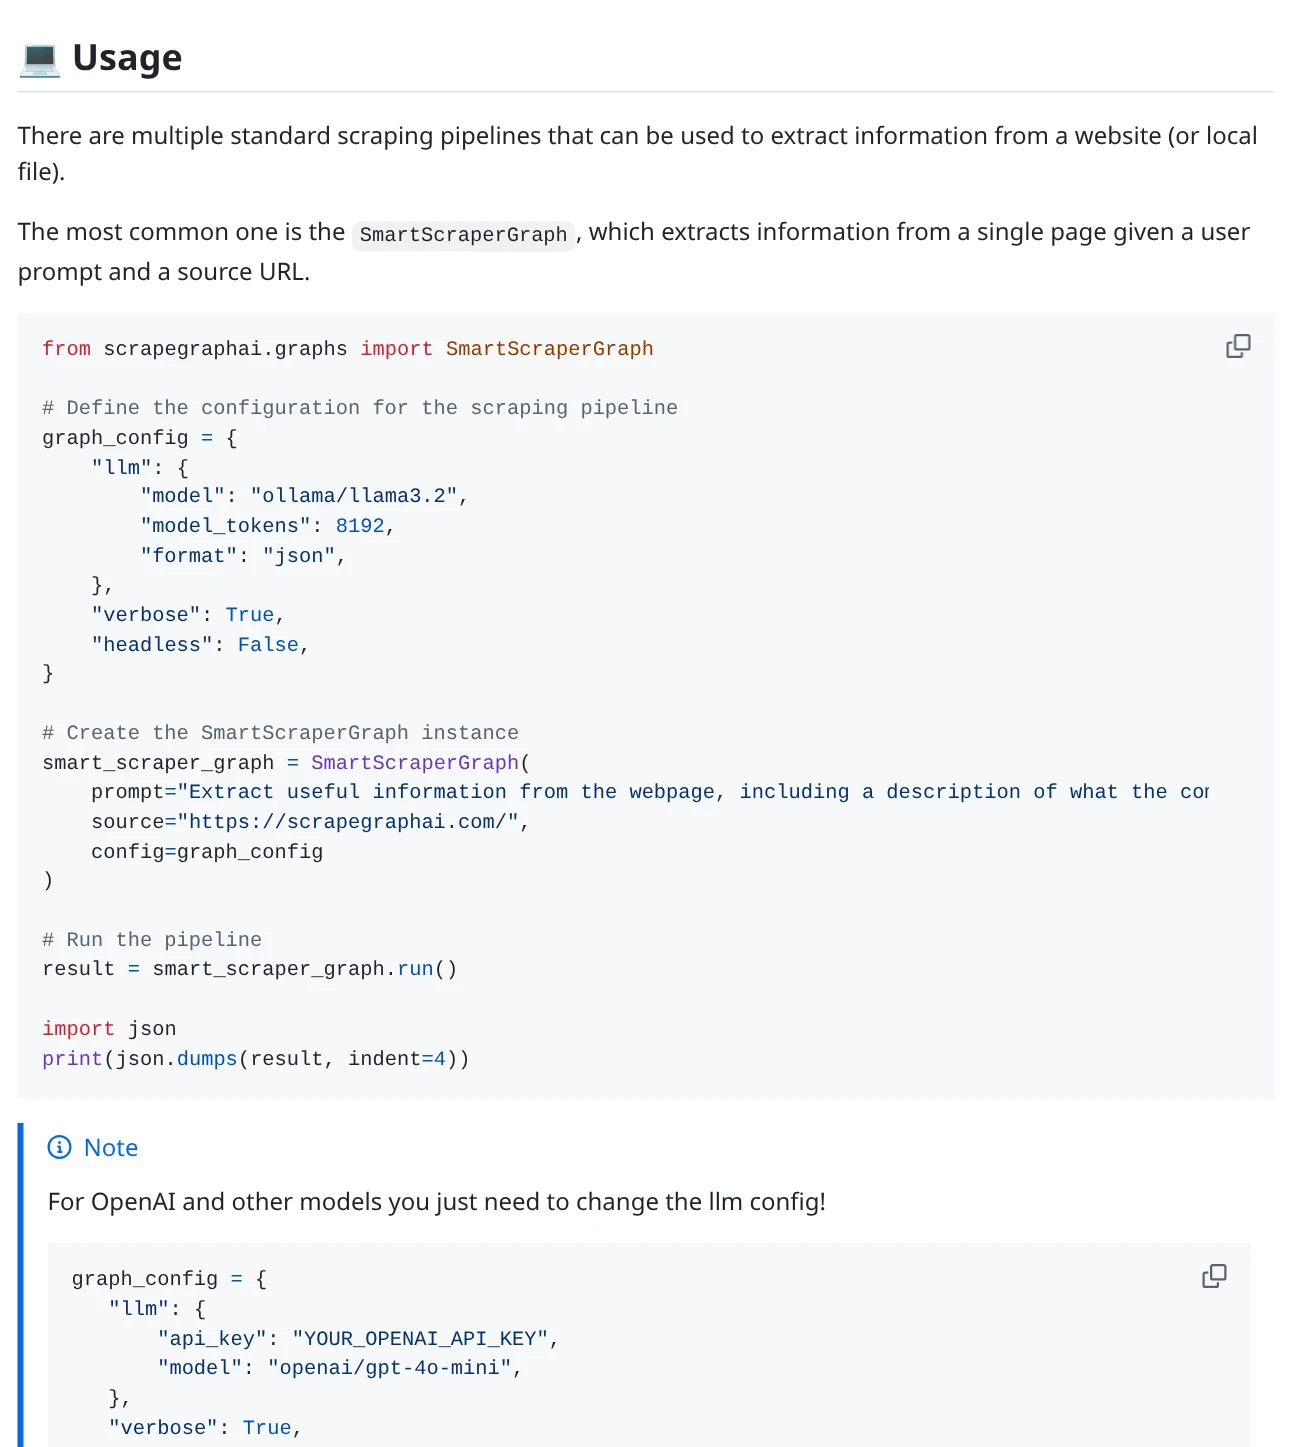
5. ScrapeGraphAI: Trích xuất có cấu trúc dựa trên LLM
Kho chính thức:https://github.com/ScrapeGraphAI/Scrapegraph-ai
ScrapeGraphAI sử dụng các mô hình ngôn ngữ lớn và quy trình đồ thị để xây dựng các đường thu thập các trang web và tài liệu cục bộ. README chính thức mô tả rằng nó có thể xử lý các trang web, cũng như các tài liệu địa phương như XML, HTML, JSON, Markdown; Thư viện nguồn mở và APP quản lý đang ở vị trí vận hành, LLM、 Có sự khác biệt giữa các mô hình render, proxy và phí của trình duyệt.
Nhà trọ kỹ thuật:Python Giấy phép:MIT (thư viện Python nguồn mở) Quản lý API như một dịch vụ độc lập)
- Nhiệm vụ trích xuất có thể được mô tả xung quanh trường mục tiêu, giảm công việc của bộ chọn phần bảo trì thủ công.
- Thích hợp đưa trang web vào quy trình trích xuất thông tin thống nhất với tài liệu địa phương.
- Các thư viện nguồn mở được cấp phép MIT và có thể chạy trong cơ sở hạ tầng riêng.
- Các phiên bản nguồn mở tự lưu trữ yêu cầu cấu hình LLM, trình duyệt/Playwright, proxy và cơ sở hạ tầng mở rộng của riêng họ.
- Đầu ra LLM vẫn cần được kiểm tra và không thể được coi là dữ liệu thực tế hoàn toàn chính xác theo mặc định.
Phù hợp với cảnh:Thích hợp cho các nhóm Python cần chuyển đổi trang web hoặc tài liệu thành các trường JSON cụ thể và sẵn sàng cấu hình mô hình và môi trường chạy của riêng họ.
Scrapy: Framework thu thập dữ liệu Python trưởng thành
Kho chính thức:https://github.com/scrapy/scrapy
Scrapy là một framework thu thập dữ liệu và trích xuất dữ liệu có cấu trúc cấp cao. Kho chính thức định vị nó như là một framework web scraping đa nền tảng, phù hợp để xây dựng các dự án thu thập có thể bảo trì thông qua Spider, lập lịch yêu cầu và quy trình xử lý dữ liệu.
Nhà trọ kỹ thuật:Python (Python 3.11+) Giấy phép:BSD-3-Clause
- Thích hợp cho các dự án thu thập dữ liệu trang web có cấu trúc rõ ràng, quy tắc rõ ràng và cần bảo trì lâu dài.
- Sinh thái trưởng thành, thích hợp tổ chức Spider, yêu cầu, phân tích và xuất dữ liệu.
- Giấy phép BSD-3-Clause, phù hợp để kết hợp nhiều loại dự án phần mềm (vẫn yêu cầu giấy phép).
- Yêu cầu một nền tảng Python nhất định và tự thiết kế các quy tắc phân tích trang đích.
- Đối với các trang phụ thuộc nhiều vào JavaScript front-end, thường yêu cầu một sơ đồ render trình duyệt bổ sung.
Phù hợp với cảnh:Thích hợp với danh mục công khai thương mại điện tử, lưu trữ tin tức, danh mục tài liệu và các trang có cấu trúc khác.
7. Playwright: Cơ sở hạ tầng tự động hóa trình duyệt
Kho chính thức:https://github.com/microsoft/playwright
Playwright là một framework kiểm tra web và tự động hóa trình duyệt cung cấp cho Chromium, Firefox và WebKit một API thống nhất. Nó xử lý các trang, tương tác biểu mẫu, chờ trang, ảnh chụp màn hình và kiểm tra trình duyệt yêu cầu JavaScript thực hiện, nhưng bản thân nó không phải là một nền tảng quản lý dữ liệu và lập lịch trình thu thập dữ liệu hoàn chỉnh.
Nhà trọ kỹ thuật:Các ràng buộc chính thức cho JavaScript/TypeScript, Python, Java,.NET, v.v. Giấy phép:Apache-2.0
- Giao diện tự động hóa trình duyệt thống nhất trên Chromium, Firefox, WebKit.
- Thích hợp để xử lý kết xuất front-end, quy trình tương tác và ảnh chụp màn hình trang.
- Có thể hoạt động như một trình duyệt thực thi cho các framework thu thập thông tin như Crawlee.
- Hàng đợi URL, lưu trữ dữ liệu, lập lịch thu thập dữ liệu và phân tích nội dung thường cần phải tự thực hiện hoặc kết hợp với các khung khác.
- Trình duyệt thực sử dụng nhiều tài nguyên hơn để chạy so với các yêu cầu HTTP đơn giản.
Phù hợp với cảnh:Thích hợp cho các trang hiển thị JavaScript, kiểm tra trang web tương tác và cung cấp khả năng thực thi trình duyệt cho các dự án thu thập dữ liệu khác.
Scrapling: Phân tích thích ứng và thu thập dữ liệu
Kho chính thức:https://github.com/D4Vinci/Scrapling
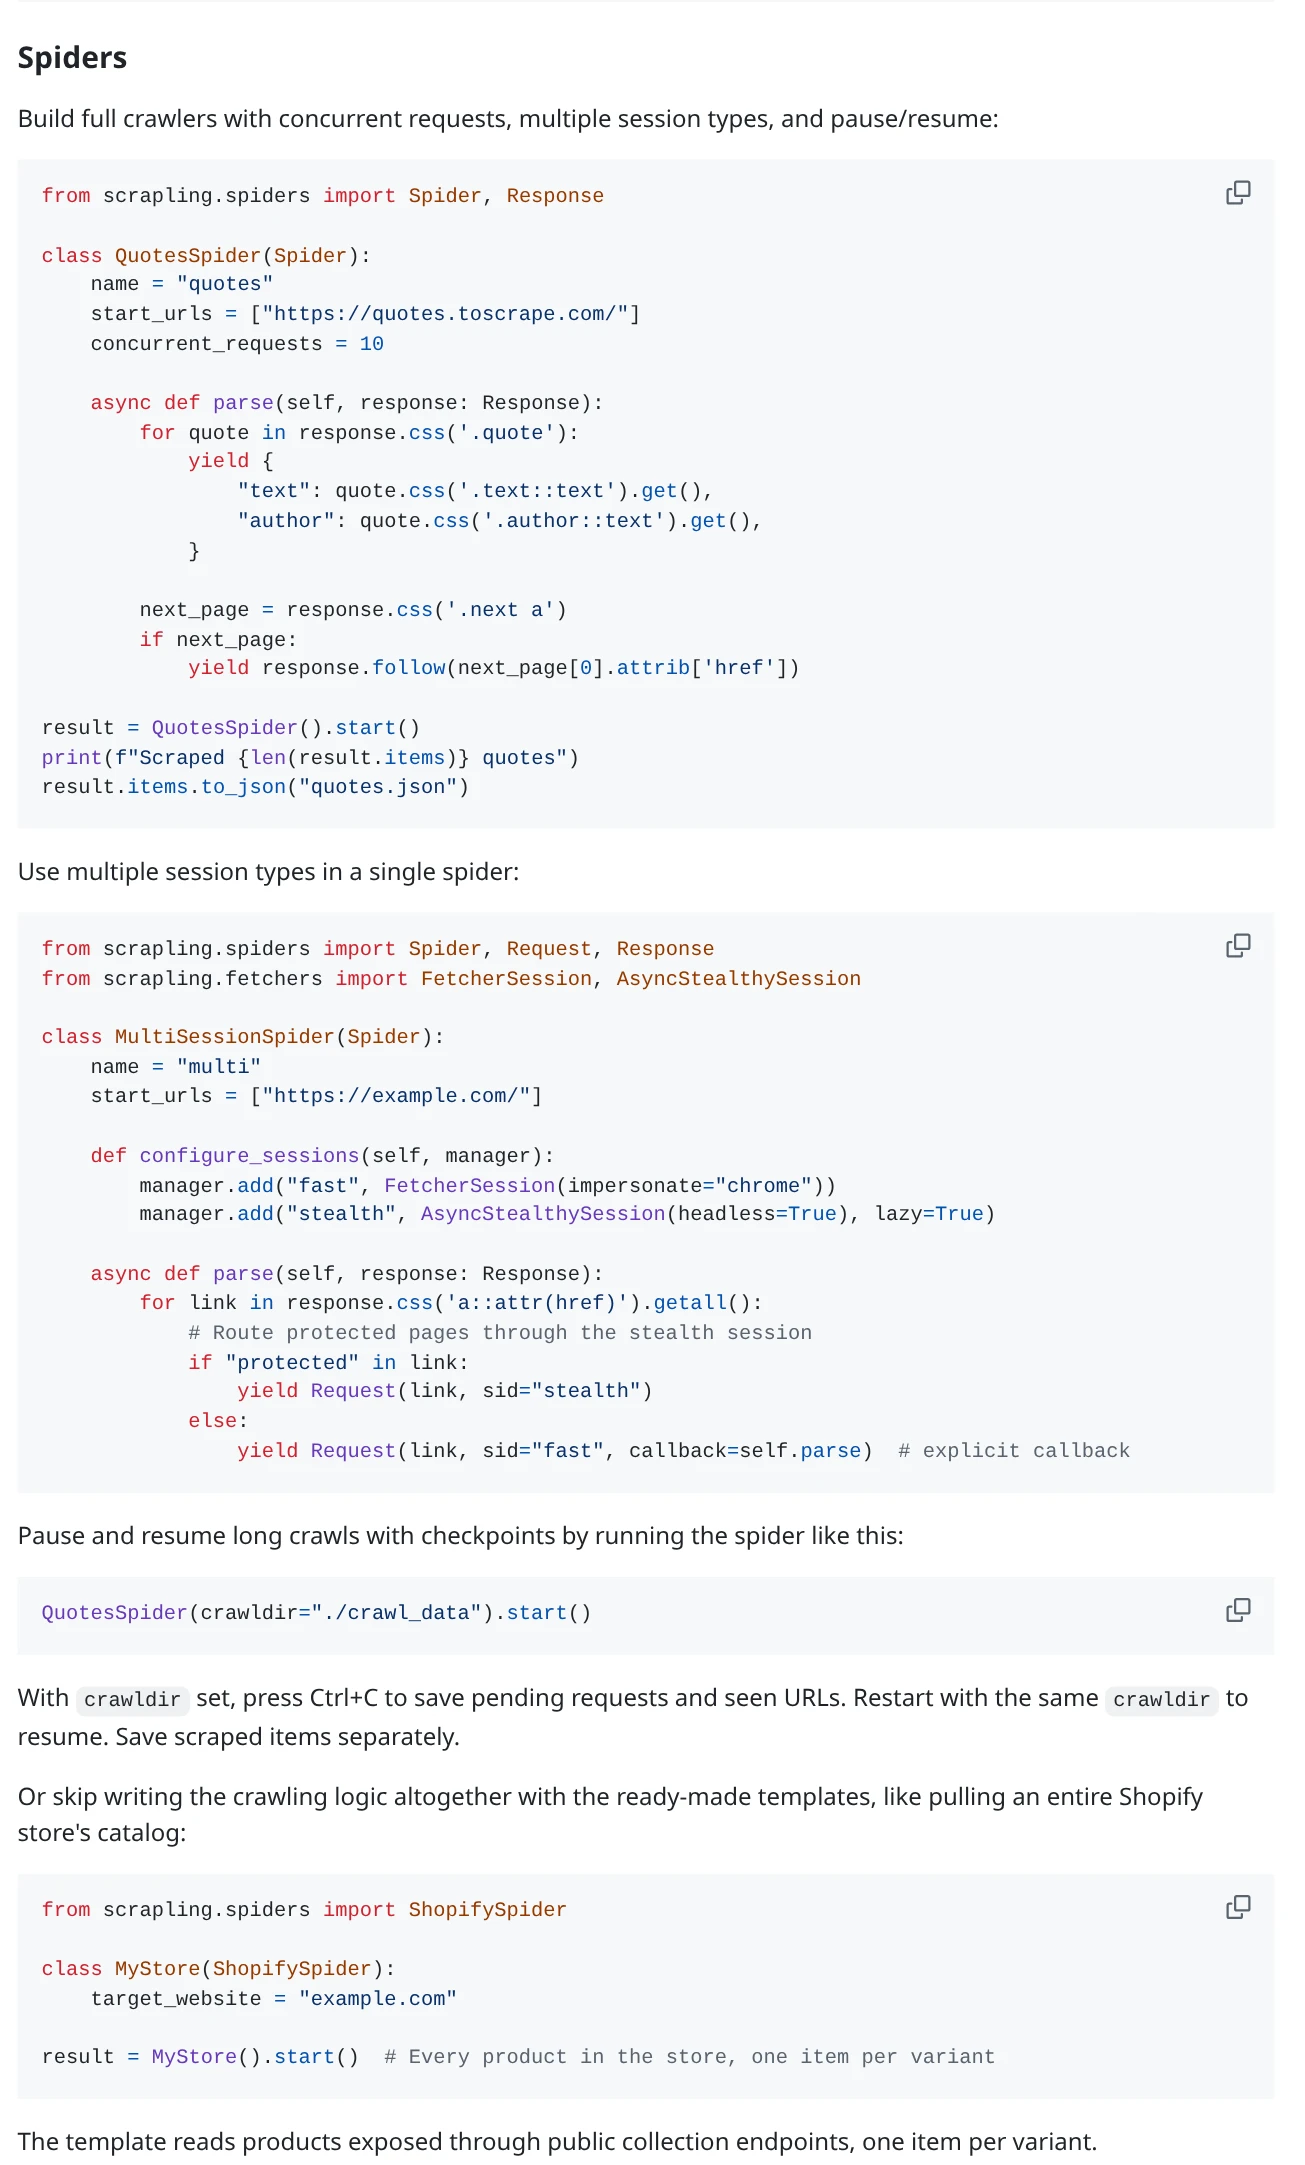
Scrapling tổ chức HTTP Scrapling, trình duyệt Fetcher, Resolution và Concurrent Spider trong cùng một bộ công cụ Python. Khả năng phân tích thích ứng của nó được sử dụng để định vị lại các phần tử sau khi thay đổi cấu trúc trang; README chính thức cũng liệt kê các tính năng như quản lý phiên, xoay proxy, thử lại, tạm dừng/khôi phục và JSON, JSONL, CSV, xuất XML, v.v.
Nhà trọ kỹ thuật:Python (kích thước README chính thức Python 3.10+) Giấy phép:BSD-3-Clause
- Độ phân giải thích ứng có thể làm giảm chi phí bảo trì bộ chọn do một số thay đổi DOM trên trang.
- Có thể mở rộng từ yêu cầu một trang đến Spider đồng thời.
- Cung cấp phiên, xoay proxy, thử lại và nhiều khả năng xuất dữ liệu.
- Cài đặt cơ bản không giống như các tùy chọn phụ thuộc như trình duyệt Fetcher/Spider, và extras cần được cài đặt theo tài liệu chính thức trước khi kích hoạt chức năng trình duyệt.
- Phân tích thích ứng không đảm bảo rằng tất cả các trang web được sửa đổi mà không cần bảo trì con người.
Phù hợp với cảnh:Thích hợp cho các nhà phát triển Python để xử lý các dự án có cấu trúc DOM thay đổi thường xuyên và đòi hỏi nhiều cách thu thập dữ liệu.
Puppeteer: Điều khiển trình duyệt Node.js
Kho chính thức:https://github.com/puppeteer/puppeteer
Puppeteer là một thư viện JavaScript điều khiển Chrome hoặc Firefox thông qua DevTools Protocol hoặc WebDriver BiDi, chạy ở chế độ Headless theo mặc định. Các ứng dụng phổ biến được liệt kê trong các tài liệu chính thức bao gồm tự động hóa biểu mẫu, kiểm tra giao diện người dùng, ảnh chụp màn hình trang, tạo PDF và thu thập dữ liệu các ứng dụng một trang và tạo nội dung được kết xuất trước.
Nhà trọ kỹ thuật:JavaScript / Node.js Giấy phép:Apache-2.0
- Khả năng kiểm soát trình duyệt Chrome/Firefox rất chi tiết.
- Thích hợp chụp màn hình, PDF、 Hành động biểu mẫu và các trang yêu cầu trình duyệt thực hiện.
- Nó có thể được kết hợp với các framework như Crawlee để bổ sung khả năng lập kế hoạch nhiệm vụ và quản lý dữ liệu.
- Nó chủ yếu chịu trách nhiệm kiểm soát trình duyệt, không cung cấp quản lý dự án thu thập dữ liệu hoàn chỉnh.
- Các phiên bản trình duyệt yêu cầu thêm CPU, bộ nhớ và bảo trì chạy.
Phù hợp với cảnh:Thích hợp cho nhóm Node.js để kiểm soát trình duyệt, ảnh chụp màn hình trang, tạo PDF và thu thập nội dung SPA.
Cấu hình Colly: Go Language Crawler Framework
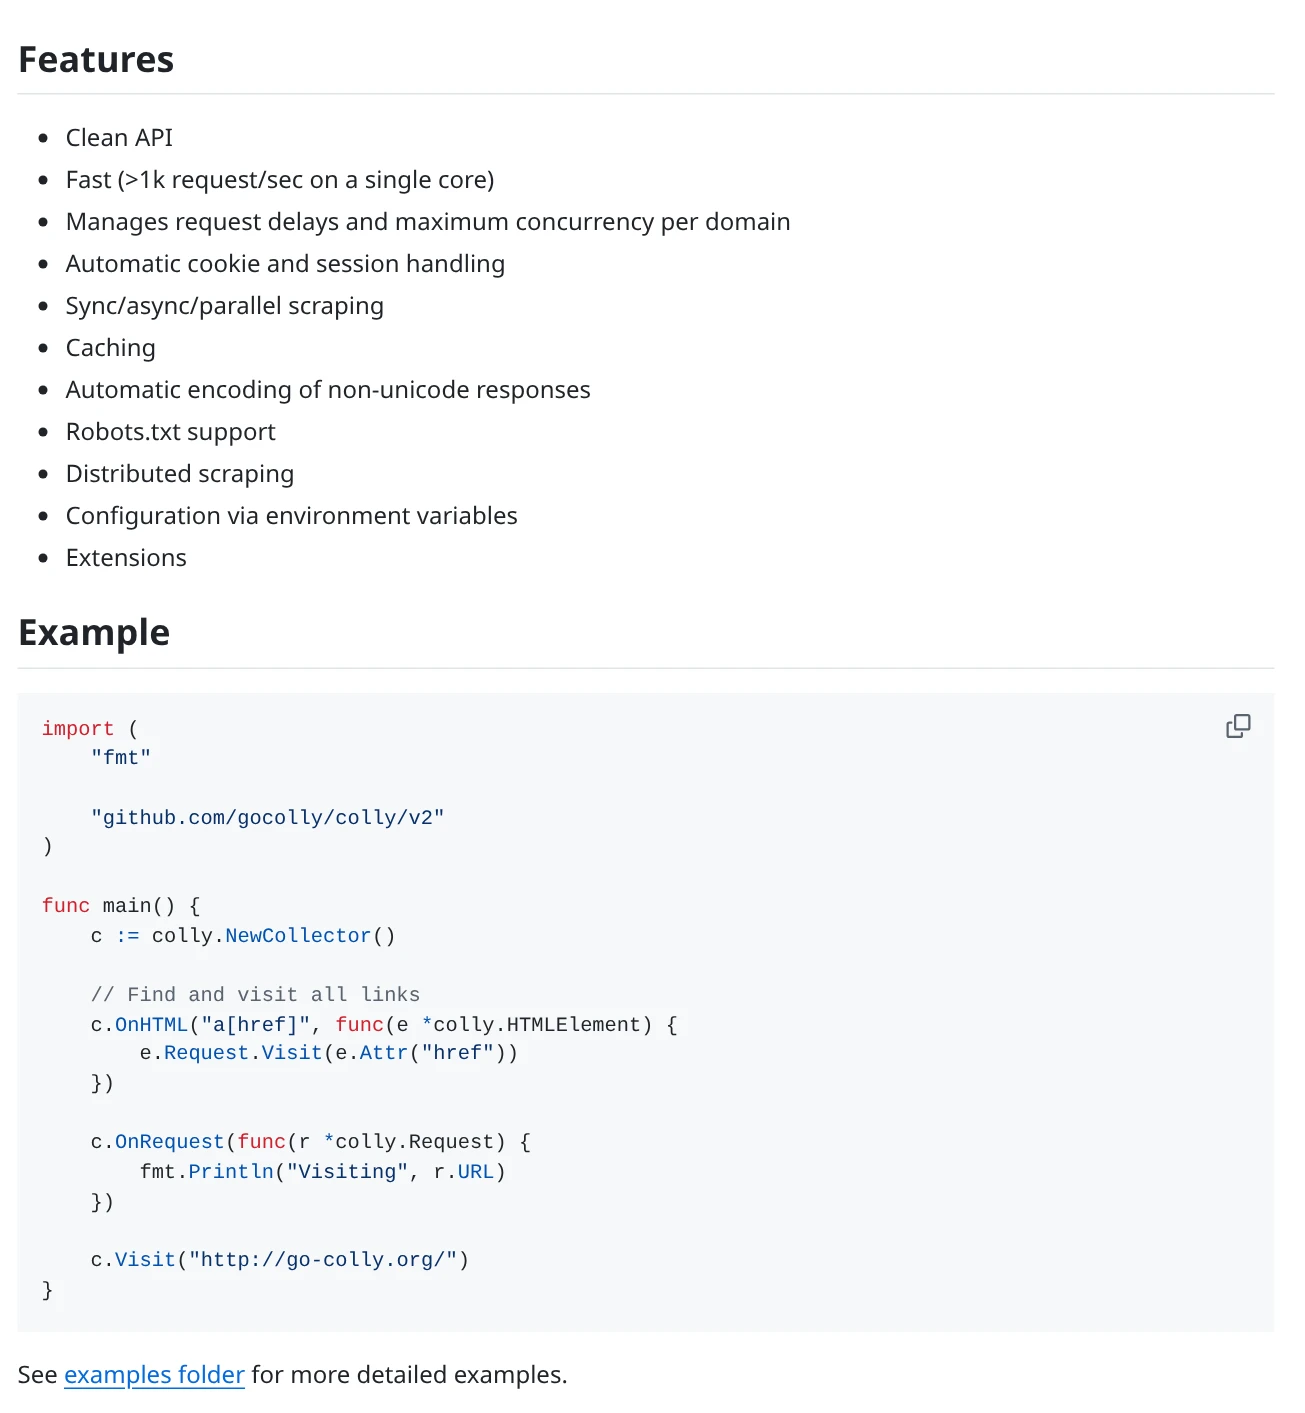
Kho chính thức:https://github.com/gocolly/colly
Colly là một web crawling framework và data crawling cho ngôn ngữ Go. Các tính năng được liệt kê trong kho chính thức bao gồm trì hoãn yêu cầu và đồng thời tối đa theo tên miền, xử lý cookie và phiên, thu thập dữ liệu đồng bộ/không đồng bộ/song song, bộ nhớ cache, hỗ trợ robots.txt và thu thập dữ liệu phân tán.
Nhà trọ kỹ thuật:Go Giấy phép:Apache-2.0
- Thích hợp với chồng kỹ thuật Go và nhiệm vụ thu thập yêu cầu HTTP.
- Độ trễ và giới hạn đồng thời có thể được đặt theo tên miền để dễ dàng kiểm soát nhịp độ truy cập.
- Hỗ trợ cookie, bộ nhớ cache, robots.txt và thu thập dữ liệu phân tán.
- Chủ yếu hướng tới HTTP Grab; Các trang yêu cầu trình duyệt thực hiện JavaScript nên xem xét các công cụ tự động hóa trình duyệt.
- Yêu cầu khả năng phát triển Go và tự thiết kế đầu ra dữ liệu, giám sát và triển khai nhiệm vụ.
Phù hợp với cảnh:Thích hợp cho việc thu thập các trang web, thư mục và nội dung trang web công khai có cấu trúc tương đối ổn định.
Ba, mười dự án chọn thế nào? Bảng so sánh nhanh
| dự án | Định vị chính | Ngôn ngữ/Công nghệ Stack | Giấy phép | Cảnh ưu tiên |
|---|---|---|---|---|
| Firecrawl | Tìm kiếm trang web, thu thập dữ liệu và cấu trúc nội dung | TypeScript/Node.js Sinh thái | AGPL-3.0 (lõi) | Bộ sưu tập AI/RAG |
| Crawl4AI | Trình thu thập không đồng bộ thân thiện LLM | Python | Apache-2.0 | Chuyển sang Markdown/JSON |
| Browser Use | Trình duyệt AI Agent | Python | MIT (Thư viện nguồn mở) | Tác vụ tương tác nhiều bước |
| Crawlee | Khung thu thập dữ liệu cấp sản xuất | TypeScript / JavaScript | Apache-2.0 | Queue, Session và Browser Scraping |
| ScrapeGraphAI | Khai thác sơ đồ LLM | Python | MIT (Thư viện nguồn mở) | Trích xuất trang web và tài liệu theo trường |
| Scrapy | Thu thập dữ liệu trang web có cấu trúc | Python | BSD-3-Clause | Dự án thu thập bảo trì dài hạn |
| Playwright | Tự động hóa trình duyệt/Kiểm tra | Đa ngôn ngữ ràng buộc | Apache-2.0 | Trang động và tương tác |
| Scrapling | Phân tích thích ứng với Concurrent Grab | Python | BSD-3-Clause | Cấu trúc trang thay đổi nhiều hơn |
| Puppeteer | Điều khiển Chrome/Firefox | JavaScript / Node.js | Apache-2.0 | Ảnh chụp màn hình, PDF, trang spa |
| Colly | Giao diện HTTP Grab Framework | Go | Apache-2.0 | Go Tech Stack và Concurrency Request |
Đề xuất lựa chọn đơn giản:Nếu bạn chủ yếu thu thập dữ liệu các trang web có cấu trúc, hãy bắt đầu với Scrapy hoặc Colly; Nếu trang yêu cầu trình duyệt chạy JavaScript, hãy ưu tiên đánh giá Playwright hoặc Puppeteer; Nếu dự án muốn chuyển đổi trang web thành ngôn ngữ AI, hãy so sánh Firecrawl, Crawl4AI và ScrapeGraphAI; Nếu bạn cần Agent thực hiện nhiều bước, hãy xem Browser Use.
B5-05=giá trị thông số Kd, (cài 2)
10 mục trên chủ yếu chịu trách nhiệm về "cách phát hiện trang, đọc nội dung, phân tích trường hoặc thực hiện tương tác trang web". Khi một nhóm cũng cần quản lý các môi trường làm việc trình duyệt khác nhau, cấu hình proxy và tự động hóa các quy trình trình duyệt, lớp môi trường chạy trình duyệt cần được xem xét.
ovo Browser được định vị để kết nối quản lý môi trường trình duyệt với tự động hóa, không phải là framework thu thập dữ liệu. Nó không thay thế lịch trình thu thập dữ liệu, phân tích nội dung và khả năng lưu trữ dữ liệu của Scrapy, Crawlee hoặc Firecrawl; Nó có thể hoạt động như một lớp kết nối giữa môi trường trình duyệt và các công cụ tự động hóa.
1. ovo Browser Chromium kho hạt nhân
Kho công cộng chính thức:ovobrowsersupport/ovobrowser。
Kho README định vị nó như một nhân vân tay Chromium được sửa đổi cấp nguồn và cung cấp các ví dụ về gói di động Windows x64 với các nhà phát triển. Warehouse Notes liệt kê các cấu hình liên quan như Canvas, WebGL, Audio, ClientRects, Font và các ví dụ khởi động cho các ngôn ngữ như Python, Node.js, Go, C #, PowerShell, Java, Rust. Kích thước trang kho Giấy phép MIT.
Cần phân biệt:Kho này dành cho các nhà phát triển, chứa mô tả gói di động hạt nhân và ví dụ khởi động; Nó không phải là một framework thu thập dữ liệu web và không bằng toàn bộ mã nguồn của trình duyệt đồ họa ovo Browser.
2. ovo Browser đồ họa khách hàng giới thiệu kho
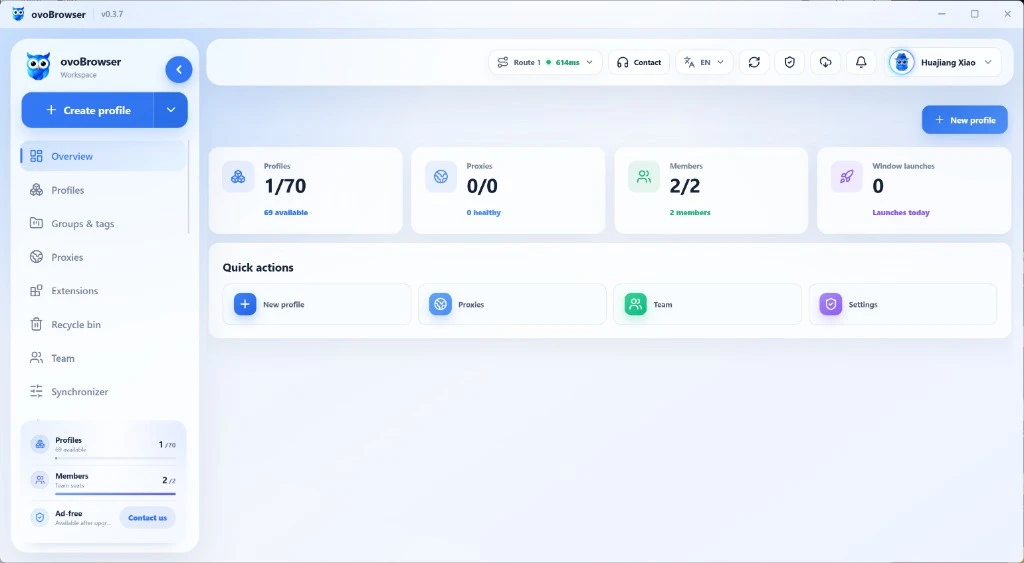
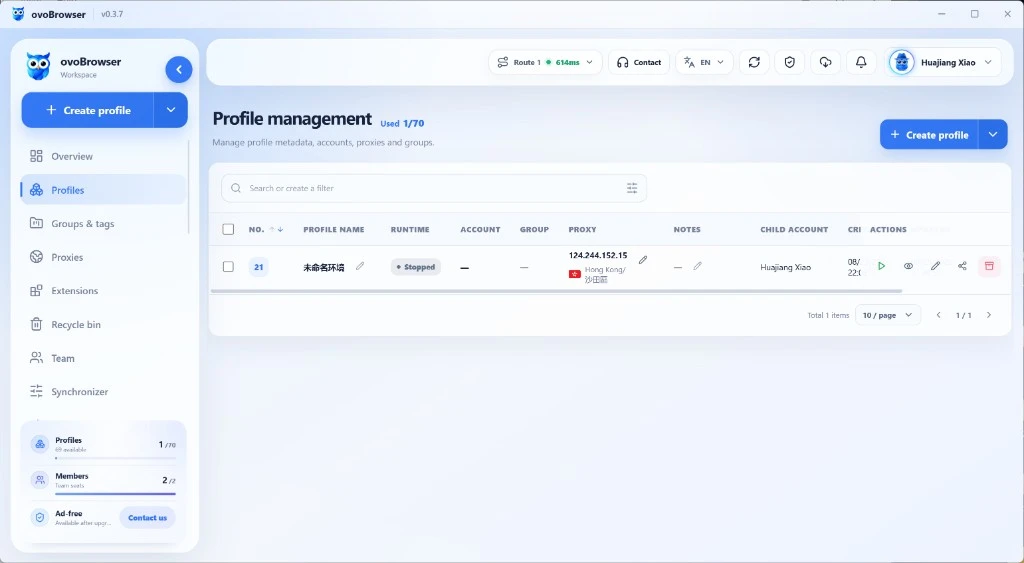
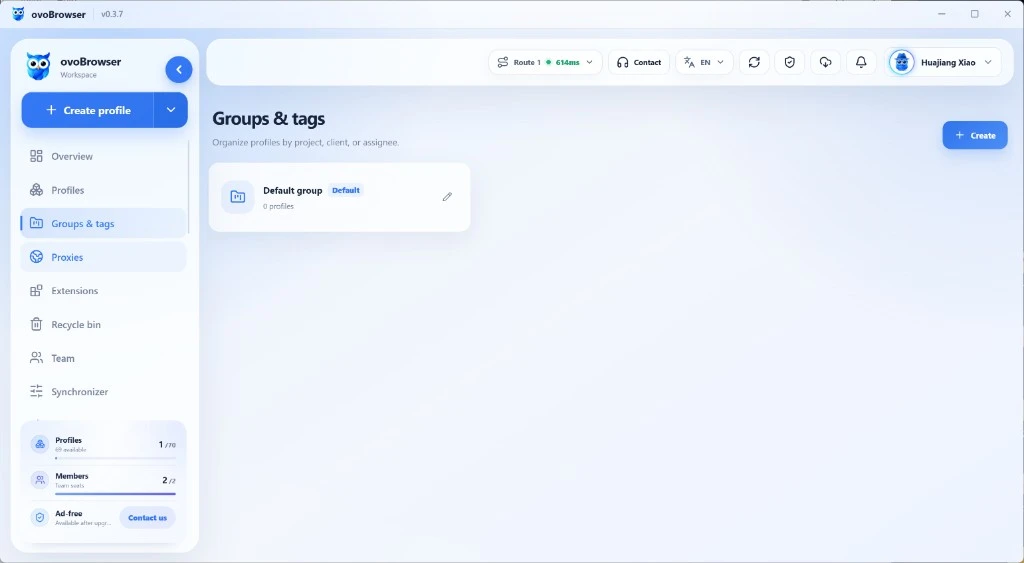
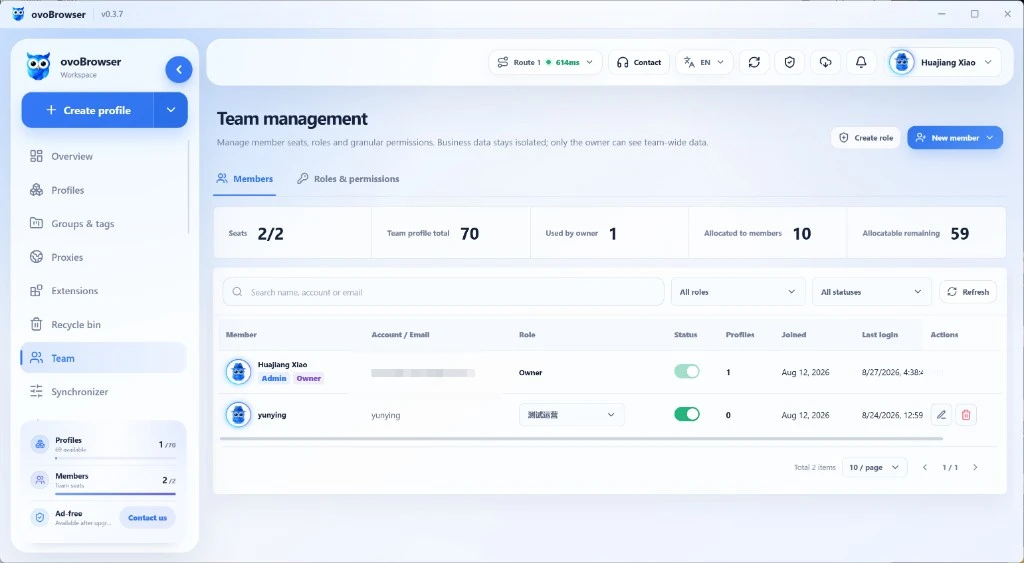
Kho công cộng chính thức:ovobrowsersupport/ovobrowser-manger. Kho README mô tả nó như là một giới thiệu máy tính để bàn khách hàng và ảnh chụp màn hình dữ liệu cho người dùng bình thường, mô tả rằng môi trường trình duyệt, proxy, nhóm và đồng bộ hóa cửa sổ có thể được quản lý trong giao diện đồ họa.
Phiên bản client screenshot được đánh dấu trong README là v0.3.7. Hình ảnh dưới đây từ danh mục tài liệu/tài sản của kho chính thức này, thuộc về ảnh chụp màn hình sản phẩm thực tế; Nếu giao diện khách hàng đã được cập nhật tại thời điểm phát hành, nó nên được thay thế bằng ảnh chụp màn hình phiên bản hiện tại và phiên bản được đánh dấu trong chú thích.
ovo Browser Local API: Cho phép các công cụ tự động kết nối với môi trường trình duyệt
Tài liệu hướng dẫn API cục bộ chính thức của ovo Browser, API HTTP cục bộ quản lý môi trường trình duyệt, nhóm, thẻ, proxy, thùng rác và quy trình trình duyệt. Sử dụng POST+JSON Body Các giao diện được liệt kê trong tài liệu bao gồm danh sách môi trường, môi trường tạo/cập nhật, quản lý proxy và môi trường trình duyệt mở, truy vấn và đóng.
Sau khi mở môi trường, phản hồi API sẽ trở lại. pid、ws、http Thông tin; Tài liệu chính thức nói rõ, trả về ws Nó có thể được sử dụng bởi Playwright hoặc Puppeteer. Điều này cung cấp một lối vào để kết nối quản lý môi trường của ovo Browser với mã tự động hóa trình duyệt hiện có.
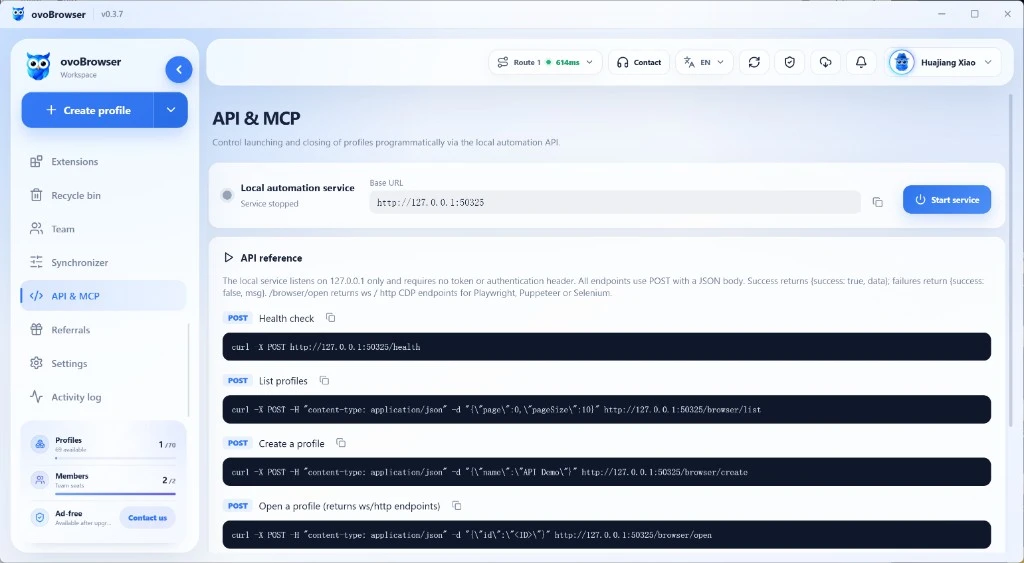
Ví dụ về yêu cầu môi trường mở trong tài liệu chính thức:
curl --location 'http://127.0.0.1:50325/browser/open' \
  --header 'Content-Type: application/json' \
  --data '{"id":"YOUR_PROFILE_ID","headless":false}'
Sau khi yêu cầu thành công, phản hồi sẽ chứa thông tin về quá trình kết nối với trình duyệt. Nhà phát triển có thể quay lại theo tài liệu chính thức ws Cung cấp cho Playwright hoặc Puppeteer; Mã kết nối cụ thể phải dựa trên phiên bản máy khách hiện tại và tài liệu API chính thức của bạn.
4. Một trình duyệt ovo rõ ràng hơn+quy trình thu thập dữ liệu nguồn mở
- Chọn Acquisition Framework:Chọn Scrapy, Crawlee, Crawl4AI theo tác vụ hoặc sử dụng Playwright/Puppeteer để xử lý các trang yêu cầu trình duyệt thực hiện.
- Tạo môi trường browser:Tạo và đặt tên môi trường theo dự án trong ovo Browser và cấu hình proxy theo nhu cầu mạng thực tế.
- Mở môi trường thông qua API cục bộ:Sử dụng API cục bộ để mở môi trường được chỉ định, đọc thông tin kết nối trình duyệt trong phản hồi.
- Công cụ tự động hóa kết nối:Thông tin kết nối được đưa cho Playwright hoặc Puppeteer theo tài liệu chính thức, nơi các nhà phát triển viết truy cập trang, chờ đợi, trích xuất và lưu logic.
- Quản lý dữ liệu và nhịp truy cập:Lưu kết quả thu thập vào cơ sở dữ liệu hoặc tệp của riêng bạn và đặt đồng thời hợp lý, độ trễ và thử lại không thành công.
5. Cân nhắc bảo mật khi sử dụng API cục bộ ovo Browser
Tài liệu API chính thức của ovo Browser cho biết các API cục bộ chỉ lắng nghe 127.0.0.1và không yêu cầu Token, Bearer Token hoặc x-api-keyDo đó, dịch vụ chỉ nên được sử dụng cục bộ và không để lộ các cổng API cục bộ với mạng công cộng hoặc mạng cục bộ không đáng tin cậy. Tài liệu chính thức cũng cảnh báo rằng số tài khoản, cookie, khóa 2FA và mật khẩu proxy là thông tin nhạy cảm và không được ghi vào nhật ký công khai.
Ngoài ra, cách ly môi trường trình duyệt và cấu hình proxy không có nghĩa là bạn có thể bỏ qua kiểm soát truy cập của trang web mục tiêu. Nhà phát triển phải tuân thủ điều khoản dịch vụ của website mục tiêu, robots.txt、 Yêu cầu về quyền riêng tư, quy tắc bản quyền và luật hiện hành; Cần có sự cho phép thích hợp trước tiên đối với nội dung yêu cầu đăng nhập, trả tiền, dữ liệu cá nhân hoặc quyền truy cập tự động bị cấm rõ ràng.
V. Câu hỏi thường gặp
Dự án thu thập dữ liệu mã nguồn mở GitHub hoàn toàn miễn phí?
Giấy phép nguồn mở cho phép người dùng sử dụng, sửa đổi hoặc phân phối mã trong các điều kiện tương ứng, nhưng không có nghĩa là chi phí chạy bằng không. Các chi phí có thể phát sinh cho máy chủ, proxy, tài nguyên chạy trình duyệt, API LLM và dịch vụ đám mây được quản lý; Các nghĩa vụ đối với giấy phép như AGPL, Apache, MIT, BSD cũng khác nhau và các tệp LICENSE trong thư mục gốc của dự án nên được xem trước khi sử dụng thương mại.
Scrapy, Playwright và Firecrawl là gì?
Scrapy phù hợp hơn cho việc thu thập trang web có cấu trúc truyền thống; Playwright là một khung kiểm tra và tự động hóa trình duyệt phù hợp để xử lý các tương tác trang và render JavaScript; Firecrawl hướng đến việc thu thập dữ liệu nội dung web, tìm kiếm và đầu ra có cấu trúc, đặc biệt phù hợp với quy trình làm việc AI/RAG. Ba vấn đề giải quyết khác nhau, cũng có thể kết hợp sử dụng trong cùng một hệ thống.
ovo Browser có phải là phần mềm thu thập dữ liệu không?
Không phải. ovo Browser chủ yếu được sử dụng để quản lý môi trường trình duyệt, proxy và kết nối tự động. Các tác vụ như lập kế hoạch URL thực tế, phân tích cú pháp trang web, làm sạch dữ liệu, ghi cơ sở dữ liệu, v.v. vẫn cần được thực hiện bởi Scrapy, Crawlee, Firecrawl hoặc mã của nhà phát triển.
ovo Browser có thể kết nối Playwright hoặc Puppeteer không?
Hướng dẫn khách hàng chính thức của ovo Browser và tài liệu API cục bộ mô tả cách kết nối với Playwright và Puppeteer. API chính thức trả về thông tin kết nối trình duyệt sau khi mở môi trường, trong đó ws Có sẵn cho Playwright hoặc Puppeteer. Thực hiện cụ thể hãy lấy tài liệu phiên bản hiện hành làm chuẩn.
Sử dụng dự án thu thập dữ liệu có đảm bảo không bị hạn chế bởi trang web không?
Không thể. Không có khung hoặc cấu hình trình duyệt nào có thể đảm bảo rằng trang web đích luôn cho phép truy cập tự động. Các quy tắc trang web mục tiêu nên được tuân thủ và tần suất truy cập hợp lý được thiết lập; Không cố gắng phá vỡ các kiểm soát truy cập trái phép khi gặp phải từ chối truy cập, mã xác minh, tường đăng nhập hoặc hạn chế truy cập.
Kết luận: Chọn đúng công cụ trước khi xây dựng quy trình làm việc ổn định và tuân thủ
Hệ sinh thái trình thu thập dữ liệu mã nguồn mở trên GitHub đã bao gồm nhiều cấp độ từ thu thập dữ liệu HTTP đơn giản đến tự động hóa trình duyệt, trích xuất có cấu trúc AI. Scrapy và Colly phù hợp cho việc thu thập thông thường, Crawlee phù hợp để xây dựng các dự án với hàng đợi và quản lý phiên, Playwright và Puppeteer kiểm soát trình duyệt và Firecrawl, Crawl4AI và ScrapeGraphAI phù hợp cho nội dung trang web vào quy trình làm việc AI.
Nếu dự án cũng yêu cầu quản lý độc lập môi trường trình duyệt và kết nối nó với các chương trình tự động hiện có, bạn có thể tìm hiểu thêm về kho hạt nhân GitHub chính thức của ovo Browser với API cục bộ. Để mỗi công cụ chịu trách nhiệm về những gì nó giỏi thường đáng tin cậy hơn là mong đợi một phần mềm duy nhất làm tất cả.
Truy cập trang web ovo Browser để tìm hiểu về khả năng quản lý và tự động hóa môi trường trình duyệt
Tài liệu tham khảo và các nguồn chính thức
- Video tổng hợp báo cáo tin tức dựa trên luật sử dụng hợp lý – Fair use for news reporting ((
- Firecrawl GitHub chính thức
- Crawl4AI chính thức GitHub
- Browser Use GitHub chính thức
- Crawlee chính thức GitHub
- ScrapeGraphAI chính thức GitHub
- Scrapy GitHub chính thức
- Playwright chính thức GitHub
- Scrapling GitHub chính thức
- Puppeteer GitHub chính thức
- Colly chính thức GitHub
- Trình duyệt ovo Chromium Kernel Warehouse
- ovo Browser giới thiệu khách hàng và ảnh chụp màn hình kho
- Tài liệu chính thức của ovo Browser Local API
Bài viết liên quan
2026 Hướng dẫn phát triển trang chủ Facebook
Đối với thương mại điện tử xuyên biên giới, các thương hiệu nước ngoài và các nhóm hoạt động truyền thông xã hội, tăng trưởng trang chủ Facebook không chỉ đơn giản là tăng số lượng bài đăng, mà là liên tục cung cấp nội dung gốc có giá trị, xây dựng vị trí thương hiệu rõ ràng, phản hồi kịp thời với khán giả và điều chỉnh hướng nội dung dựa trên dữ liệu. Bài viết này bắt đầu với việc chuẩn bị trang chủ, lập kế hoạch nội dung, nhịp độ hoạt động 30 ngày, làm việc nhóm và phục hồi dữ liệu và mô tả cách ovo Browser có thể giúp các nhóm quản lý nhiều môi trường kinh doanh được cấp phép rõ ràng hơn.
Đọc bài viết
ovo Browser, GoLogin và AdsPower là gì?
Phiên bản miễn phí, tự động hóa, so sánh giá đầy đủ
Đọc bài viết
Tại sao tài khoản Claude kích hoạt xác minh, cảnh báo hoặc hạn chế?
Theo thứ tự "Trạng thái tài khoản - Khu vực và Mạng - Xác minh thanh toán - Hành vi sử dụng - Thiết bị và Phiên làm việc - Quản lý môi trường", bài viết này xem xét các phần đáng kiểm tra và mô tả cách ovo Browser có thể giúp người dùng sắp xếp môi trường làm việc của trình duyệt.
Đọc bài viết